مقدمه مترجم
درباره
پایتون
پایتون
زبانی است که ساختار بسیار زیبایی دارد. در مقایسه با زبانهای تفسیری، مانند Perl، PHP، Basic، و ... ساختار نحوی آن طوری
است که آن را زیباتر جلوه میدهد. ولی تنها حُسن این زبان در زیبایی ظاهری آن
خلاصه نمیشود. در طول سالها بر قدرت پایتون افزوده شده و تقریباً در هر حوزهای
میتوان از آن استفاده کرد، از پردازش دادههای تجاری گرفته تا انجام محاسبات علمی،
گرافیک، و بازیها.
در
مقایسه با زبانهای سُنتی مثل C،
C++ یا Pascal، تنها نقطه ضعف
پایتون در سرعت آن است، که این مورد هم طبیعی است، زیرا کُد این زبانها به زبان
ماشین کامپایل میشوند ولی کُدهای پایتون توسط مفسر آن تفسیر میشوند. خیلی از زبانها، که قدمت
آنها از پایتون نیز کمتر است (مثل Java
و C#) بدلیل سرمایهگذاریهای
کلانی که از طرف صاحبان آنها انجام گرفته، حالا به زبانهای قدرتمندی تبدیل شدهاند که سرعت آنها فاصله زیادی با
زبانهایی مثل C
یا C++ ندارد. از این لحاظ،
چون پایتون یتیم است (حداقل اگر یتیم نباشد حامیانش آنقدرها ثروتمند نیستند)،
سرمایهگذاری زیادی نیز بر روی آن انجام نگرفته، زیرا اگر چنین کاری انجام میگرفت،
پایتون هیچ چیزی کم نداشت.
ولی
همانطور که در طول این کتاب نشان داده میشود، اگر برنامهنویس برای پیادهسازی
ایدههای خودش رویکردهای مناسبی اتخاذ کند، ممکن است حتی سرعت برنامهای که به
زبان پایتون مینویسد از برنامههای مشابه به زبانهای سُنتی نیز بیشتر باشد. دلیلش
هم این است که پیادهسازی الگوریتمها در پایتون راحتتر از بسیاری از زبانهای
دیگر است. وقتی کسی به کُدهای پایتون نگاه میکند و آنها را میخواند، اگر نگوییم
شبیه یک زبان انسانی بنظر میرسند، شباهت زیادی به شِـبهکُد (Pseudocod)
دارند. همانطور که ممکن است بدانید، ایدههای اولیه یک برنامه بصورت شِبهکد نوشته
میشوند، تا بعداً به برنامههای واقعی تبدیل شوند. پس این خودش دلیلی بر این است که با
پایتون بهتر میتوان ایدهها را پیاده سازی کرد.
جایگاه
پایتون در ایران
جایگاه
این زبان را میتوان از دو جنبه تجاری و تحقیقاتی مورد بررسی قرار داد:
1- جنبه تجاری: بطور کلی مردم کمتر سراغ چیزی میروند که برای
آنها پولساز نباشد. این ایده که با زبانهایی مثل پایتون نمیشود برنامههای تجاری
یا اداری نوشت کاملاً نادرست است. برای اثبات این ادعا کافیست چند جستجوی ساده را
در اینترنت انجام دهید. در ایران نوشتن این گونه برنامهها عمدتاً با زبانهایی مثل Delphi، یا زبانهای خانواده .Net
انجام میشود. البته زبان Java
را نیز نباید از قلم انداخت. ولی اگر شرکتی مانند گوگل وجود نداشت تا سیستمی مثل اندروید را ابداع
کند و به این وسیله گروه عظیمی از برنامهنویسان را ترغیب (یا به عبارتی مجبور) به
استفاده از Java
کند، شاید این زبان در میان برنامه نویسان (ایرانی) رشد نمیکرد، و استفاده از آن
به سازمانهای بزرگ محدود میشد. دلیل عمدهای که برنامهنویسان (ایرانی) در
استفاده از پایتون مردد هستند ممکن است این باشد که آنها برای اجرای برنامههای
نوشته شده خودشان باید اصلِ برنامه را نیز در اختیار استفاده کننده قرار دهند، که
این میتواند کار سرقتِ برنامهها، یا دخل و تصرف در آنها را سادهتر کند. البته
این تا حدی درست است، ولی روشهایی نیز در دسترس هستند که توسط آنها میتوان کدهای
پایتون را به زبانهای دیگری مثل C، یا حتی EXE،
تبدیل کرد.
هر چند این روشها به تکامل نرسیدهاند ولی استفاده از آنها به مهارت برنامهنویس
بستگی دارد. نکته اصلی اینجاست که اگر شما برای سازمان یا شرکت خودتان برنامه مینویسید،
بدلیل اینکه از برنامه شما بصورت داخلی استفاده میشود، مشکل بیرون دهی منبعِ کُد
را نیز نخواهید داشت. بنابراین باید برنامهنویسان را تشویق کرد تا حداقل برای
برطرف کردن نیازهای خودشان، یا مؤسساتی که در آنجا مشغول بکار هستند، از پایتون
استفاده کنند.
2- جنبه علمی و تحقیقاتی: اگر در زمینه پروژههای تحقیقاتی کار میکنید، پایتون یکی از بهترین انتخابها برای این قبیل کارها است. در اینجا بهانههایی
که در مورد استفادههای تجاری پایتون به آنها اشاره شد اصلاً وجود ندارند. همچنین اگر دانشجو
هستید و در پروژههای (اصیل!) خود نیاز به پردازش دادهها دارید، حتماً این زبان
را امتحان کنید. در ضمیمه C
این کتاب مطالبی در مورد کاربرد پایتون در زمینههای علمی و تحقیقاتی آمده است.
از نظر
لغوی پایتون به معنای مار افعی است. در لوگوی بسیاری از کتابهایی که
درمورد زبان پایتون منتشر شده، تصویر مار افعی دیده میشود. حتی در لوگوی رسمی
سایت پایتون نیز تصویر دو مار دیده میشود.
لوگوی رسمی سایت پایتون
نکته
جالب اینجاست که نام گذاری اولیه این زبان هیچ ارتباطی با مار ندارد. داستان از
اینجا شروع میشود که خالق هلندی این زبان، یعنی گیدو ون روسوم (Guido
van Rossum)، در زمان جوانی طرفدار یک سریال کمدی بنام مانتی پایتون (Monty Python)
بود. مانتی پایتون یک سریال کمدی انگلیسی بود که در دهه 1960 و 1970 پخش میشد و معروفترین بازیگر آن جان کلیز
(John Cleese) است. اگر یک جوانِ
امروزی حالا این سریال را ببیند، نه تنها برایش خنده دار نیست، بلکه ممکن است بیمعنی
نیز بنظر برسد. پس نباید انتظار داشته باشید با دیدن این سریال چیزی از فلسفه زبان
پایتون دستگیرتان شود.
اصولاً
نباید انتظار داشت نامگذاریهایی که در تکنولوژی کامپیوتر صورت میگیرند معنای
مناسبی داشته باشند. کارشناسانِ این حوزه را غالباً جوانانی تشکیل میدهند که باذوق و
بازیگوش هستند و نامی که برای ابداعات خودشان انتخاب میکنند بیشتر به نامگذاری یک
آهنگ یا ترانه شباهت دارد! در زمانی که این نامگذاریها صورت میگیرند، سازندگان
آنها حتی تصورش را هم نمیتوانند بکنند که ممکن است سال بعد تکنولوژی ابداعی آنها
در سطح جهان فراگیر شده باشد.
این
گونه نامگذاریهای
بیمسما فقط مختصِ دنیای کامپیوتر است. در علومی مثل پزشکی، که مانند کامپیوتر
هرروزه در حال تحول است، ابداع اصطلاحات جدید خیلی جدی گرفته میشود، و حتی در
برخی دانشگاهها برای دانشجویان کلاسهای کوتاه مدتِ زبانِ لاتین برگذار میشود تا
آنها بهتر بتوانند یافتههای خودشان را نامگذاری کنند. علوم رایانهای چنان شتابان
و زودگذر هستند که همه چیز سریعاً ارزش (و معنی اولیه) خودش را از دست میدهد.
بنابراین نباید خیلی نگران اسمگذاریها در این حوزه بود.
مشکل
اصلی که وجود دارد، ترجمه این اصطلاحات است. خیلی از مترجمین اصلاً این لغات را
ترجمه نمیکنند و آنها را با املاء لاتینشان بکار میبرند. برخی نیز آنها را
ترجمه میکنند، ولی برای ترجمه این لغات از اولین معادلی که در یک فرهنگ لغت پیدا
کردند استفاده میکنند! مشکل هنگامی پیش میآید که این ترجمهها بیمعنی باشد و
بجای آگاهی بخشیدن به خواننده، موجب گمراهی و تصور غلط برای او شود.
رویکرد
مترجم در ترجمه کُتب فنی همیشه این بوده که تا آنجا که امکان دارد لغات را به
معادل فارسی آنها ترجمه کنم، ولی کار اضافهای که انجام میدهم این است که درست بعد از
لغاتِ ترجمه شده، لغت و اصطلاح اصلی را نیز در پرانتز میگذارم تا خوانندگانِ
علاقمند بتواند با لغت اصلی آشنا شوند.
از
اوایل دهه 60 شمسی در دانشگاههای مختلف ایران رشته کامپیوتر و گرایشهای مختلف آن
تدریس میشوند. نرمافزار در ایران کاملاً جا افتاده و جای تاسف دارد که برای برخی از مهمترین
مفاهیم آن هنوز اصطلاح مناسبی ابداع نشده. مواردی که مورد نظر من است ارتباطی با
تکنولوژیهای زودگذر ندارند، بلکه منظورم اصطلاحاتی است که در علوم رایانهای
کاربرد دارند.
اصولاً
واژهسازی و معادلیابیِ اصطلاحاتِ جدید به عهده مؤسساتی مثل فرهنگستان علوم است.
ولی ظاهراً آنها توجه زیادی به این حوزه نشان نمیدهند و سرعت عملشان خیلی کند
است. مثلاً، حدود 10 سال طول کشید تا برای چیزی مثل CD، اصطلاح لوح فشرده را ابداع کنند! شاید هم
آنها با همین معضلی که ما با آن روبرو هستیم مواجهاند و از ترجمه این اصطلاحات
منصرف میشوند.
در
مورد این کتاب
مدتها بود
که مترجم میخواست کتابی درمورد زبان پایتون ترجمه کند. ولی به چند دلیل از اینکار
منصرف میشدم. دلایل من برای پرهیز از اینکار عمدتاً در یک جمله خلاصه میشدند: ”فایده
این کار چیست؟“. ولی این زبان
بقدری زیباست که مرا واداشت تردیدهایم را کنار گذارم و به ترجمه این کتاب اقدام
کنم.
بر
خلاف کتابهایی که در مورد زبانهای دیگر به فارسی وجود دارد، و تعداد آنها به دهها
عدد بالغ میشود، کتابهای اندکی در مورد پایتون به زبان فارسی وجود دارد، که
بیشترشان نیز قدیمی هستند و پایتون 3 را پوشش نمیدهند.
همانطور که در ادامه این کتاب خواهید دید، دو نوع پایتون وجود دارد که به پایتون 2
و 3 معروف هستند. البته از نظر نحوی تفاوت زیادی بین این دو
وجود ندارد، ولی پایتون 3 از رشتههای یونیکد پشتیبانی میکند، و این باعث میشود برای برنامههایی که از حروف غیر-لاتین استفاده
میکنند (از جمله فارسی) مناسبتر باشد.
کتاب
حاضر یکی از جدیدترین کتابها برای یادگیری زبان پایتون است و تقریباً تمام
موضوعات مطرح در پایتون را پوشش میدهد. این کتاب در رده مقدماتی طبقهبندی میشود،
و این یعنی مبتدیان نیز میتوانند از آن استفاده کنند، ولی درجای خود به موضوعات
پیشرفته نیز اشاره میشود.
از این نظر کتاب جامعی نیز محسوب میشود.
درباره
نویسنده
نویسنده
این کتاب بیل لوبانویچ (Bill Lubanovic) در سال 1947 متولد
شد، ابتدا تحصیلات خود را در رشته بیولوژی ادامه داد و در سال 1973 مدرک کارشناسی،
و در سال 1980 دکترای خود را در زمینه زیستشناسی گرفت. با اینکه رشته او در ابتدا
علوم بود، ولی از سال 1975 به کامپیوتر گرایش پیدا کرد و از آن پس در سازمانهای
مختلف بعنوان کارشناس ارشد نرمافزار مشغول بکار بوده است. از کتابهای او به
موارد زیر میتوان اشاره کرد:
·
Linux System Administration. US 2008 Authors: Bill Lubanovic, Tom Adelstein
· Linux Server
Security, 2nd Edition. US 2005 Authors: Bill Lubanovic, Michael Bauer
مقدمه
مؤلف
این کتاب
مقدمهای بر برنامهنویسی به زبان
پایتون است. مخاطب این کتاب برنامه نویسان مبتدی هستند، ولی حتی اگر شما با برنامهنویسی آشنایی دارید، و قصد دارید پایتون را نیز به لیست زبانهایی که میدانید اضافه کنید، کتاب ”مقدمهای بر زبان پایتون“ نقطه شروع خوبی برای اینکار است.
ما
در این کتاب برای معرفی مفاهیم گوناگون خیلی عجله بخرج نمیدهیم، کارمان را از مفاهیم اولیه شروع کرده و با گامهایی کوتاه به موضوعات پیشرفتهتر میپردازیم. سبکی که برای توضیح اصطلاحات
و ایدههای جدید اتخاذ شده، مخلوطی از یک خودآموز و
یک کتاب راهنما است. در این کتاب خیلی زود با برنامههای واقعی پایتون روبرو میشوید.
هر
چند این یک کتاب مقدماتی است، ولی در آن موضوعاتی را مطرح کردهام که ممکن است پیشرفته بنظر برسند، چیزهایی مثل پایگاههای NoSQL و کتابخانههای رد و بدل
پیام. دلیل اینکه چنین
موضوعاتی را در این کتاب گنجاندهام این است که آنها میتوانند برخی مسائل را بهتر از راهحلهای استاندارد حل کنند. اصطلاحی در پایتون هست که میگوید ”پایتون باطری سَرخود است“، ولی اگر این باطریها ضعیف شوند، شما برای انجام کارهای خود میتوانید پکیجهای خارجی را دانلود کرده و آنها را بر روی
کامپیوتر خود نصب کنید.
همچنین
به برخی کارهایی که نباید آنها را انجام دهید اشاره میکنم، خصوصاً به کارهایی که در زبانهای دیگر معمول هستند و ممکن است به آنها عادت کرده باشید. من مدعی نیستم که
پایتون یک زبان کامل است و میتواند بخوبی هر کاری را انجام دهد. من به مواردی
اشاره خواهم کرد که باید از انجام آنها در پایتون پرهیز شود
مخاطبین
این کتاب
این کتاب
میتواند برای هر کسی که به یادگیری زبانهای کامپیوتری علاقه داشته باشد، چه آنهایی که قبلاً زبانهای دیگری را یادگرفتهاند، و چه مبتدیان، مفید باشد.
رئوس
موضوعات
ما در هفت
فصل نخست این کتاب اصول پایتون را شرح میدهیم، و اگر با
این موضوعات آشنا نیستید، باید آنها را به ترتیب فصول مطالعه کنید. فصول بعدی کاربرد
پایتون در حوزههای مختلف، از قبیل وِب، پایگاهداده، شبکه، و غیره را نشان میدهد، و شما میتوانید به هر ترتیبی که مایلید آنها را مطالعه کنید. در سه ضمیمه نخست کتاب
کاربرد پایتون در هنر، تجارت، و علوم بررسی خواهند شد.
هشدارها
و نکتهها
شما در
این کتاب دو نوع پنجره را خواهید دید:
نسخههای مختلف پایتون
همانطور
که برنامهنویسان ویژگیهای جدیدی را طلب میکنند، یا کمبودهای گذشته را پیدا میکنند، زبانهای کامپیوتری نیز همگام با آنها تغییر میکنند. مثالهای که در این کتاب آمده با پایتون نسخه 3.3
نوشته، و آزمایش شدهاند. اگر میخواهید تفاوتهایی که میان نسخههای مختلف پایتون وجود دارند را بدانید، میتوانید به این صفحه رجوع کنید:
https://docs.python.org/3/whatsnew
مثالها و تمرینهای مطرح شده در کتاب
برای
دانلود مثالها و تمرینها این کتاب، میتوانید به این صفحه رجوع کنید:
https://github.com/madscheme/introducing-python
فصل 1
مروری بر
پایتون
بیایید با
این سئوال ساده شروع کنیم، آیا ارزش دارد برای یادگیری پایتون تلاش کرد و روی آن
وقت گذاشت؟ آیا این زبان به یک مُد زودگذر شبیه است؟ یا شاید هم یک اسباببازی باشد؟ در واقع قدمت این زبان به سال 1991 بازمیگردد (چند سال پیش از پیدایش زبان جاوا)، و از آن زمان تا کنون در میان
محبوبترین زبانهای برنامهنویسی، همیشه جزء 10تای نخست بوده. دستمزدهای زیادی به برنامهنویسان پرداخت میشود تا به این زبان برنامه بنویسند، برنامههای مهمی که بسیاری از مردم همهروزه از آن استفاده میکنند؛ مثلاً گوگل (Google)،
یوتیوب (YouTube)،
دروپباکس (Dropbox)،
نتفلیکس (Netflix)،
و هولو (Hulu).
من خودم سالها است که برای برنامههای مختلفی همچون جستجوی ایمیل و سایتهای تجارتِ الکترونیک از این زبان استفاده میکنم. شهرت پایتون در سازمانهای رو به رشد در بهرهوری آن است.
در
بسیاری از محیطهای نرمافزاری از پایتون استفاده میشود، مثلاً:
·
خط فرمان (command line)
پنجره ترمینال.
· میانجیهای
گرافیکی کاربر (GUI)، از
جمله وب (Web).
·
در برنامهنویسی وب، از پایتون هم در سرویسگیرندهها (client)
و هم در سرویسدهندهها (server)
استفاده میشود.
·
سِرورهایی که از سایتهای بزرگ و پرطرفدار پشتیبانی میکنند.
·
کلادها (clouds)، یا به عبارتی، سرورهایی که توسط اشخاص ثالث
مدیریت میشوند.
·
دستگاههای موبایل.
·
دستگاههای توکار (Embedded
devices).
برنامههای پایتون دامنه وسیعی
دارند؛ از اسکریپتهای تک خطی گرفته تا پروژههای چند- میلیون
خطی. ما به کاربردهای این زبان در وبسایتها، مدیریت سیستمها، و پردازش دادهها نگاهی خواهیم افکند. همچنین به کاربردهای خاص پایتون در علوم، هنر، و تجارت
نیز اشاره خواهیم
کرد.
مقایسه
پایتون با زبانهای دیگر
مقام
پایتون در مقایسه با زبانهای دیگر چیست؟ شما در کجا و چه موقع یکی از این زبانها
را به دیگری ترجیح خواهید داد؟ در این بخش من از هرکدام از این زبانها یک برنامه نمونه خواهم آورد، تا
ببینید رقابت این زبانها میتواند به چه شکل باشد. اگر قبلاً با این
زبانها کار نکردهاید، قرار
نیست آنها را درک کنید. (و زمانی که نهایتاً با پایتون آشنا شدید، ممکن است
آسوده خاطر شوید که تا به حال مجبور نبودهاید با برخی از
آنها کار کنید!) اگر فقط میخواهید با پایتون آشنا شوید، با گذشتن از
این بخش چیزی را از دست نخواهید داد.
هر
یک از این برنامهها قرار است عددی را چاپ کرده و به دنبال آن
شعاری را درباره آن زبان نمایش دهند.
اگر
از یک پنجره ترمینال استفاده میکنید، برنامهای که ورودی شما را خوانده، آن را اجراء کرده و نهایتاً نتایجِ حاصله را نشان
میدهد، برنامه واسط یا برنامه پوسته (shell)
نامیده میشود. برنامه واسط ویندوز cmd
است و برنامههای گروهی را اجرا میکند که پسوند آنها .bat
است. سیستم عامل لینوکس، و دیگر سیستمهای یونیکس- مانند، (از جمله Mac OS X)
برنامههای واسط زیادی دارند، که محبوبترین آنها bash
یا sh نامیده میشود. برنامه واسط قابلیتهای اندکی را در خود دارد، مثلاً میتواند مقایسههای منطقی انجام دهد و یا علامتهای
جايگزين شونده
(wildcard)، (نظیر *) را به نامفایلها گسترش دهد.
شما
میتوانید این قبیل دستورات را در فایلهایی که اسکریپتهای واسط (shell scripts)
نامیده میشوند ذخیره کنید تا بعداً اجراء شوند. این
قبیل اسکریپتها ممکن است اولین برنامههایی باشند که شما بعنوان یک برنامهنویس با آنها
موجه میشوید. مشکل این قبیل برنامهها این است که نمیتوانند از چند صد خط بیشتر شوند، و سرعت آنها
نیز از برنامههای دیگر کمتر است. در زیر نمونهای از یک اسکریپت واسط آمده است:
#!/bin/sh
language=0
echo "Language $language: I am the shell. So
there."
اگر
خطوط بالا را در فایلی بنام meh.sh ذخیره کرده و آن را
با sh اجراء کنید، نتیجه زیر در صفحه شما ظاهر
خواهد شد:
Language
0: I am the
shell. So there.
زبانهای قدیمی و قدرتمندی همچون C
و C++، تا حدودی سطح پایین
محسوب میشوند، و هنگامی که سرعت اجراء اهمیت داشته
باشد از آنها استفاده میشود. یادگیری این زبانها دشوارتر است، و لازم است شما جزئیات زیادی را مد نظر قرار دهید، جزئیاتی که
میتواند به سقوط برنامه (crash)،
و نیز مشکلاتی منتهی شود که تشخیص آنها دشوار است. در زیر نمونهای از یک برنامه به زبان C
دیده میشود:
#include <stdio.h>
int main(int argc, char *argv[]) {
int language = 1;
printf("Language %d:
I am C! Behold me and tremble!\n", language);
return 0;
}
زبان C++ نیز از خانواده C است و شباهت
زیادی با آن دارد:
#include
<iostream>
using namespace std;
int main() {
int language = 2;
cout << "Language " <<
language << \
": I am C++! Pay no attention to that
C behind the curtain!" << \
endl;
return(0);
}
زبان Java
و C# جانشینان C و C++ هستند که از برخی از مشکلات ذکر شده دوری
کردهاند، ولی باز هم تا اندازهای طولانی و دست و پاگیر هستند. در زیر نمونهای از یک برنامه جاوا را مشاهده میکنید:
public class Overlord {
public static void main (String[] args) {
int language = 3;
System.out.format("Language
%d: I am Java! Scarier than C!\n", language);
}
}
درصورتی
که شما تابحال با این زبانها برنامهای ننوشتهاید، ممکن است از
خود بپرسید که معنی همه اینها چیست؟ برخی از زبانها کولهبار سنگینی از دستورات نحوی را با خود دارند. این زبانها گاهی اوقات زبانهای
ایستا (static languages)
نیز نامیده میشوند، دلیلش هم این است که در این زبانها لازم است
جزئیات زیادی برای کامپیوتر مشخص شود. اجازه دهید این موضوع را بیشتر توضیح دهم.
همه زبانهای کامپیوتری چیزی بنام متغیر دارند (متغیر نامی است که برای مقادیری که
در برنامه تغییر میکنند از آنها استفاده میشود). در زبانهای ایستا شما مجبور هستید تا گونه (type)
هر متغیر را دقیقاً اعلان (declare)
کنید: با اینکار شما به کامپیوتر خواهید گفت که این متغیر چه مقدار از حافظه را
اشغال میکند، و چه کاری را میتوان با آن انجام داد. کامپیوتر از این اطلاعات برای کامپایل کردن (compile)
برنامه استفاده میکند تا آن را به زبان بسیار سطح-پایینی
ترجمه کند که زبان ماشین (machine
language) نام دارد (زبانی که فهم آن برای سختافزار کامپیوتر راحت، ولی برای انسان بسیار مشکل است). طراحان زبانهای کامپیوتری غالباً با این تصمیم روبرو هستند که آیا فهم زبانی که طراحی میکنند باید برای انسانها آسانتر باشد و یا برای کامپیوترها. از
پیش اعلان کردن متغیرها به کامپیوتر کمک میکند تا از پیدایش
برخی اشتباهات جلوگیری کند و نیز باعث میشود تا برنامهها با سرعت بیشتری اجراء شوند. ولی اینکار برای برنامهنویس به دقت بیشتر، و همچنین تایپ کردن حروف بیشتری، نیاز دارد. بیشتر حجم
کُدهایی که در مورد زبانهایی مثل C، C++، و Java مشاهده کردید به اعلان
متغیرها در این زبانها مربوط هستند. برای نمونه، در تمام این
مثالها خطی وجود دارد که با int شروع میشود و به کامپیوتر میفهماند که باید با متغیر language بعنوان یک عدد
صحیح رفتار
کند. (گونههای دیگری از متغیرها نیز وجود دارند که
شامل اعدادِ ممیزِ شناور و حروف متنی میشوند، ولی هر یک از این گونهها به روشهای متفاوتی در حافظه کامپیوتر ذخیره میشوند.)
ولی
چرا این گونه زبانها به ”زبانهای ایستا“ معروف هستند؟ دلیلش این
است که در این زبانها گونهِ متغیر ثابت (ایستا) است. یعنی اگر متغیری بعنوان یک عدد صحیح اعلان شد، این متغیر تا آخر کار خود یک عدد صحیح باقی خواهد ماند.
درمقابل
زبانهای پویا (dynamic languages)،
که به زبانهای اسکریپتی (scripting) نیز معرفند، شما را
مجبور نمیکنند تا گونه بخصوصی را برای یک متغیر اعلان کنید. در این زبانها اگر شما عبارت x = 5 را تایپ کنید،
آنها میدانند که چون 5 یک عدد صحیح است، پس متغیر x
نیز از همین گونه است. این زبانها به شما اجازه میدهند تا با نوشتن خطوط کمتر، عملکردهای بیشتری را حاصل کنید. این زبانها بجای
اینکه ترجمه شوند، توسط برنامهای بنام مفسر (interpreter)
تفسیر میشوند. زبانهای پویا غالباً آهستهتر از زبانهای ایستا هستند، ولی بعلت بهینه
شدن مفسرها در طول سالهای گذشته، سرعت آنها نسبت به قبل بهبود یافته. مدتها بود که
از زبانهای پویا فقط برای نوشتن برنامههای کوتاه، که اسکریپت (script)
نام دارند، استفاده میشد تا توسط آنها دادههایی را آماده کنند که بعداً باید توسط برنامههایی مورد پردازش قرار گیرند که به زبانهای ایستا نوشته شدهاند. به این روند ”چسباندن برنامهها به یکدیگر“ نیز میگویند (Glue code). هر چند قبلاً زبانهای پویا در این زمینهها بکار گرفته میشدند، ولی امروزه آنها به تنهایی قادر به انجام اکثر پردازشهای سنگین نیز هستند.
زبان
همه منظورهِ پویایی که سالها از آن استفاده میشد، Perl نام
دارد. پِرل بسیار قدرتمند است و کتابخانههای گستردهای دارد. ولی با اینحال ساختار دستوری آن (syntax)
میتواند زشت بنظر برسد، و اینطور که پیش میرود این
زبان در سالهای اخیر محبوبیت گذشته خود را به زبانهایی مثل پایتون و روبی (Ruby)
واگذار کرده است. در زیر نمونهای از یک برنامه به زبان پرل را مشاهده میکنید:
my $language = 4;
print "Language
$language: I am Perl, the camel of languages.\n";
Ruby زبان جدیدتری است که ساختار خود را کمی از پِرل
قرض گرفته، و دلیل محبوبیتش هم بیشتر بخاطر یک سیستم توسعه وِب است که ”روبی آن ریلز“ (Ruby on
Rails) نام دارد. کاربرد این زبان نیز مانند بیشتر حوزههایی است که از پایتون استفاده میشود، و انتخاب میان این دو بیشتر به سلیقه
برنامهنویس و یا موجود بودن کتابخانهها برای نوشتن یک برنامه بخصوص بستگی دارد.
در زیر نمونهای از یک برنامه روبی را میبینید:
language = 5
puts "Language #{language}: I am Ruby, ready and
aglow."
PHP زبان دیگری است که در میان برنامه نویسان وِب بسیار
طرفدار دارد، دلیلش هم این است که این زبان کارِ ترکیب برنامه با HTML را سادهتر میکند. با اینحال
زبان PHP نیز کاستیهای خود را دارد. همچنین PHP خارج از حوزه برنامهنویسی وِب نتوانسته محبوبیت زیادی را بعنوان
یک زبان عمومی برای خود کسب کند. نمونهای از یک کُد PHP در زیر دیده میشود:
<?PHP
$language
= 6;
echo "Language $language: I am PHP.
The web is <i>mine</i>, I say.\n";
?>
معادل
این کُدها را در زیر میبینید که به زبان پایتون نوشته شده:
language = 7
print("Language %s:
I am Python. What's for supper?" % language)
چرا
پایتون؟
پایتون یک
زبان سطح-بالا، و همه-منظوره است. این زبان طوری طراحی شده که کُدهای آن بسیار
خوانا باشند. اهمیت این مسئله بیش از آن است که بنظر میرسد. همه برنامهها فقط یک بار نوشته میشوند، ولی بارها و بارها توسط افراد مختلف خوانده و مورد تجدید نظر قرار میگیرند. خوانا بود یک برنامه همچنین باعث میشود تا درک و یادگیری آن آسانتر شود، که این هم باعث راحتتر شدن برنامهنویسی به چنین زبانهایی میشود. در مقایسه با زبانهای پرطرفدار دیگر، پایتون منحنی یادگیری
ملایمتری دارد که باعث میشود شما زودتر به مرهله بهروری برسید. در عین حال، این زبان عُمقی نیز دارد که
هر وقت ماهرتر شدید، میتوانید به این اعماق بروید.
سادگی
پایتون باعث میشود بتوانید برنامهای بنویسید که از معادلهای آن به زبانهای ایستا، بسیار کوچکتر است. مطالعات نشان میدهد که برنامهنویسان تمایل دارند در هر روز به میزان
معینی برنامه بنویسند (فرق نمیکند به چه زبانی)، بنابراین نوشتن کُد کمتر
باعث بالاتر رفتن بهروری شما خواهد شد.
در
دانشگاههای معتبر آمریکا، محبوبترین زبان برای
یادگیری علوم رایانهای مقدماتی پایتون است. همچنین پایتون محبوبترین
زبان برای محک زدن مهارت برنامهنویسان است.
و
گذشته از اینها، پایتون مجانی نیز هست. هر برنامهای که دلتان میخواهد با پایتون بنویسید، و در هر جا که میخواهید از آن استفاده کنید.
پایتون
تقریباً در همه جا اجراء میشود و خودکفا نیز هست، به این شکل که در
کتابخانههای استاندارد خودش به میزان کافی از توابع
مختلف برای کارهای گوناگون پشتیبانی میکند.
ولی
شاید بهترین دلیل برای استفاده از پایتون غیرهمترقبهترین آنها باشد، و آن این است که مردم
عموماً پایتون را دوست دارند. آنها بجای اینکه این زبان را به چشم ابزاری
برای انجام برخی کارها بنگرند، حقیقتاً از برنامه نویسی با آن لذت میبرند. آنها اگر مجبور شوند با زبانهای دیگر کار کنند، اغلب میگویند که برای فُلان ویژگی که
در پایتون وجود دارد، دلشان تنگ شده. و این چیزی است که پایتون را از بیشتر زبانها متمایز میکند.
چه
موقع از پایتون استفاده نکنیم؟
پایتون
بهترین گزینه برای انجام هر کاری نیست.
این
زبان بطور پیشفرض در همه جا نصب نشده. اگر شما قبلاً
پایتون را نصب نکردهاید، در ضمیمه D این کتاب طریقه نصب آن آمده
است.
پایتون
برای انجام بیشتر کارها به اندازهکافی قوی هست، ولی ممکن است برای انجام برخی
کارها سریع نباشد. اگر بیشتر وقت برنامه شما صرف کارهای محاسباتی میشود (که اصطلاحاً به این نوع برنامهها چسییده-به-CPU [CPU-bound] میگوید)، اگر این برنامه به زبانهایی مثل C، C++ و یا Java نوشته شود معمولاً سریعتر از معادل
آن به زبان پایتون خواهد بود. ولی نه همیشه!
·
برخی اوقات یک الگوریتم خوب در پایتون، بهتر یک الگوریتم بد در C جواب میدهد. سرعت توسعه
برنامه در پایتون
به شما این فرصت را میدهد که به جستجوی راههای بهتر بپردازید.
·
در بسیاری از برنامهها، هنگامی که باید از سرور پاسخی برسد، برنامه در حالت سکون بسر میبرد و در این حالت CPU نقشی بر عهده ندارد، در نتیجه زمان انجام کار در یک زبان پویا و ایستا تفاوت زیادی نمیکند.
·
مفسر استاندارد پایتون به زبان C نوشته شده و میتواند توسط برنامههای C
نیز توسعه یابد. من
بعداً در بخش ”بهینه کردن برنامهها“ بیشتر به این موضوع خواهم پرداخت.
·
هرساله سرعت مفسرهای پایتون
بیشتر شده. حتی زبانی
مثل جاوا هم در ابتدای کار خود
بسیار کند بود، و فقط وقتی به وضع کنونی خود رسید که تحقیقات زیادی روی آن انجام
گرفت و هزینه هنگفتی صرف بهبود سرعت آن شد. پایتون تحت تملک هیچ شرکتی نیست،
بنابراین افزایش کیفیت آن نیز بیشتر تدریجی بوده است. در بخش ”PyPy“
من درباره پروژه PyPy و دلیل بوجود آمدن آن
صحبت خواهم کرد.
·
علیرغم تمام تلاشهای که میکنید، باز هم ممکن است برنامهای داشته باشید که حقیقتاً به توان بالاتری
نیاز داشته باشد. در
این صورت از زبانهای دیگر چون C،
C++، Java، و یا زبان جدیدتری بنام Go استفاده کنید، که مدعی است به آسانی پایتون است، ولی
قدرت C را دارد.
پایتون
2 در مقابل پایتون 3
بزرگترین
مشکلی که شما در پایتون با آن موجه میشوید این است که
دو نسخه از این زبان موجود است. پایتون 2 از خیلی وقت
پیش در دسترس بوده و بطور پیشفرض، بر روی
سیستمهای لینوکسی، و همینطور کامپیوترهای اپل نصب شده
است. پایتون 2 زبان خیلی خوبی است،
ولی هیچ چیزی نمیتواند کامل باشد. مانند هر حوزه دیگری، در
زبانهای کامپیوتری نیز برخی اشتباهات روی میدهند که سطحی هستند و میتوان براحتی آنها را اصلاح کرد، ولی برخی
دیگر نیز هستند که اصلاح آنها بسیار مشکل است. اصلاحاتی که در این موارد بر روی
پایتون صورت گرفته باعث میشود تا برنامههای جدیدی که از الگوهای اصلاح شده پیروی میکنند با سیستم قدیمی پایتون (یعنی نسخه 2) ناسازگار باشند، و
در نتیجه برنامههای قدیمی بر روی سیستم جدید کار نخواهند کرد.
گوئیدو ون روسوم (Guido van
Rossum) سازنده پایتون، و دیگر دست اندرکاران تصمیم گرفتند اصلاحات عمیقی را در این
زبان بوجود آورند و نام آن را پایتون 3 گذاشتند. به گفته
آنها پایتون 2 به گذشته تعلق دارد، و پایتون 3 به آینده. آخرین نسخه
پایتون 2 نسخه 2.7 است، و برای مدت
طولانی از آن پشتیبانی خواهد شد، ولی این آخر خط است؛ دیگر هیچ موقع پایتونی بیرون
نخواهد آمد که نسخه آن 2.8 باشد. توسعههای جدید این زبان بر روی پایتون 3 متمرکز خواهد بود.
ما
در این کتاب به معرفی پایتون 3 میپردازیم. اگر شما قبلاً از پایتون 2 استفاده میکردهاید، این نسخه تا اندازه زیادی شبیه پایتون 3
است. آشکارترین تغییری که در نسخه جدید دیده میشود طریقه فراخوانی تابع
print است. اما اساسیترین تغییری که در نسخه جدید بوجود آمده، نحوه مدیریت حروف یونیکد (Unicode)
است که در فصلهای 2 و 7 به آن میپردازم.
نصب
پایتون
بجای
اینکه این فصل را زیادی شلوغ کنم، ترجیح دادم که طریقه نصب پایتون را در ضمیمه D این کتاب شرح دهم. اگر شما
پایتون 3 را ندارید، و یا مطمئن نیستید که روی
کامپیوتر شما نصب شده، این ضمیمه را برای توضیحات بیشتر مطالعه کنید.
اجراء
پایتون
پس از
اینکه یکی از نسخههای پایتون 3 را نصب کردید،
میتوانید از آن برای اجرای مثالهایی که در این کتاب آمده، و همینطور برنامههایی که خودتان مینویسید استفاده کنید. ولی حقیقتاً چگونه یک
برنامه پایتون را باید اجراء کرد؟ دو روش اصلی برای اینکار وجود دارد:
·
مفسر محاورهای (interactive
interpreter) که به همراه پایتون آمده، این امکان را به شما میدهد که بر روی برنامههای کوچک آزمایشاتی را انجام دهید. در اینجا شما دستوراتی را خط به خط وارد میکنید و نتیجه آنها را فوراً خواهید دید. تایپ کردن دستورات و مشاهد فوری نتیجه
باعث میشود تا تجربه شما در کار با پایتون سرعت بیشتری بگیرد. من برای نمایش ویژگیهای مختلف زبان از حالت محاورهای استفاده خواهم کرد، و شما هم میتوانید عین این دستورات را در کامپیوتر خود تایپ کنید.
·
برای بقیه موارد، شما باید برنامه
پایتون خود را در یک فایل، که بطور معمول پسوند آن .py است، ذخیره کرده و
سپس با تایپ python و ذکر نام فایل ذخیره
شده در جلو آن، برنامه خود را اجراء کنید.
بیایید
تا دراینجا هر دو روش را امتحان کنیم.
بیشتر
برنامههای نمونه که در این کتاب آمده از مفسر محاورهای استفاده
میکنند. هنگامی که مثالهای ذکر شده را در کامپیوتر خود
تایپ میکنید و همان نتایج را میگیرید، شما اطمینان مییابید که در راه درستی قدم برمیدارید.
برای
شروع برنامه مفسر باید
نام برنامه اصلی را (که یا میتواند python
باشد و یا python3) تایپ کنید. در دنباله این کتاب ما فرض را بر این میگذاریم که نام برنامه اصلی پایتون، python
است.
مفسر محاورهای دقیقاً
به همان صورتی عمل میکند که پایتون روی فایلها، البته با یک استثنا: هنگامی که شما چیزی تایپ میکنید که مقداری را دارد، این مقدار بصورت خودکار توسط مفسر محاورهای برای شما چاپ میشود. برای مثال، اگر پایتون را شروع کرده و
عدد 61 را در مفسر وارد کنید، این عدد در خط بعد انعکاس یافته و چاپ خواهد شد.
در مثالهای آتی، علامتِ $ نشاندهنده آمادگی
کامپیوتر برای گرفتن دستوراتی مانند python است. هر چند ممکن است این
علامت در دستگاه شما متفاوت باشد، شما نباید آن را وارد کنید.
$ python
Python
3.3.0 (v3.3.0:bd8afb90ebf2, Sep 29 2012, 01:25:11)
[GCC
4.2.1 (Apple Inc. build 5666) (dot 3)] on darwin
Type "help", "copyright", "credits"
or "license"
for more information.
>>> 61
61
>>>
این
قابلیتِ خودکارِ چاپِ نتایج، یکی از ویژگیهای مفید مفسر محاورهای است
و ارتباطی با زبان پایتون ندارد.
ضمناً اگر
میخواهید چیزی را روی صفحه چاپ کنید، میتوانید ازprint() نیز استفاده کنید:
>>>
print(61)
61
>>>
در
فصلهای بعدی شما از برنامههای چند خطی عبور کرده و به برنامههای پایتون
طولانیتری روبرو خواهید شد.
اگر عدد 61 را در یک فایل قرار دهید و سپس آن را اجراء کنید، خطایی روی نخواهد داد.
در اینجا برنامه اجراء میشود ولی چیزی روی صفحه چاپ نمیشود. در برنامههای معمولی و غیر-محاورهای پایتون، برای اینکه چیزی نمایش داده شود، شما باید از تابع print
استفاده کنید:
print(61)
بیایید تا
یک فایل پایتون را ایجاد کرده و سپس آن را اجرا کنیم:
1.
ویرایشگر متن خود را باز کنید.
2.
خط print(61)
را وارد کنید.
3.
این متن را در فایلی بنام 61.py ذخیره کنید. مطمئن شوید که آن
را بصورت یک فایل متنی ساده
ذخیره میکنید، نه فایلهایی با فرمت RTF یا Word.
نیازی نیست تا حتماً این فایل را با پسوند .py
ذخیره کنید، ولی این کار باعث
میشود تا بدانید فایل شما از نوع برنامههای پایتون است.
4.
یک پنجره ترمینال را باز کنید.
5.
برنامه خود را توسط دستور زیر اجرا کنید:
$ python 61.py
پس از آن
خروجی زیر باید برای شما ظاهر شود:
61
آیا
61 ظاهر میشود؟ اگر چنین چیزی ظاهر شد، پس برای اجرای
نخستین برنامه پایتونتان باید به شما تبریک گفت!
در یک
سیستم پایتون واقعی، شما دستوراتی را تایپ میکنید، و این دستورات باید با ساختار نحوی (syntax)
زبان پایتون مطابقت داشته باشند. ما بجای اینکه یکباره دستور زبان پایتون را برای شما شرح دهیم، تدریجاً
در فصول آتی آنها توضیح خواهیم
داد.
اصولیترین روش برای توسعه برنامههای پایتون، استفاده از یک ویرایشگر
متن-ساده
و یک پنجره ترمینال است. ضمناً ”محیطهای
توسعه یکپارچه“، یا IDEهای خوبی نیز برای پایتون وجود دارند. معمولاً IDEها دارای ویرایشگرهای پیشرفتهای هستند و
سیستم نمایش help نیز در آنها گنجانده شده. در فصل 12 به جزئیات برخی از این برنامهها خواهیم پرداخت.
اندرزهایی
از مکتب پایتون
هر زبانِ
برنامهنویسی اسلوب خاصِ خودش را
دارد. قبلاً اشاره کردم
که روشیهای پایتونی وجود دارند که شما میتوانید از آنها پیروی کنید. در داخل پایتون چندین جمله قصار وجود دارد که
فلسفه پایتون را بصورت کوتاه بیان میکند (و تا آنجا
که میدانم، پایتون تنها زبانی است چنین چیزی را در خود
گنجانده است). برای نمایش این جملات قصار در مفسر محاورهای کافیست
عبارت import this را تاپ کنید.
>>>
import this
The Zen of Python, by Tim Peters (کلمات قصار پایتون، نوشته تیم پیترز)
Beautiful
is better than ugly.(زیبا بهتر از زشت است)
Explicit
is better than implicit. (صریح بهتر از ضمنی
است)
Simple is better than complex.
(ساده بهتر از پیچیده است)
Complex
is better than complicated. (پیچیده
بهتر از بغرنج است)
Flat is better than nested. (هموار بهتر از تودرتو است)
Sparse is better than dense. (پراکنده بهتر از متراکم است)
Readability counts. (خوانایی مهم است)
Special
cases aren't special enough to break the rules.
(حالتهای خاص آنقدرها خاص نیستند تا بواسطه آنها از
قواعد صرف نظر کنیم)
Although practicality beats purity.
(هر چند عملگرایی بر خلوص مرجح است)
Errors should never pass silently.
(هرگز نباید از خطاها بطور خاموش گذشت)
Unless explicitly silenced. (مگر اینکه آنها بطور صریح خاموش شده باشند)
In
the face of ambiguity, refuse the temptation
to guess.
(در مواجهه ابهام، از وسوسه حدس زدن اجتناب کنید)
There
should be one--and
preferably only one--obvious way to
do it.
(برای انجام یک کار، یک راه – و ترجیحاً فقط یک راه، باید وجود داشته باشد)
Although that way may not be obvious at first unless you're Dutch.
(هر چند این راه ممکن است در ابتدا برای شما آشکار نباشد، مگر اینکه شما یک هلندی باشید)
Now
is better than never.
(حالا بهتر از هرگز است)
Although
never is often better than *right* now.
(هر چند هرگز بهتر از”همین“حالا است)
If the
implementation is hard to explain, it's a bad idea.
(اگر توضیح پیاده سازی چیزی مشکل است، این ایده
خوبی نیست)
If the
implementation is easy to explain, it may be a good idea.
(اگر توضیح پیاده سازی چیزی آسان است، ممکن
است ایده خوبی باشد)
Namespaces
are one honking great idea--let's do more of those!
(فضاهای اسمی ایده بسیار خوبی هستند، بیایید
تا ایدههای مشابه بیشتری ارائه دهیم!)
من در طول
این کتاب به مضامین این جملات اشاره خواهم
کرد.
فعالیتها
این فصل
مروری بود بر زبان پایتون: آنچه
انجام میدهد، چگونه بنظر میرسد، و اینکه در دنیای کامپیوتر چه جایگاهی دارد. برای اینکه چیزهایی که در هر
فصل مطالعه میکنید را بخاطر بسپارید، در پایان هر فصل چند
پروژه کوچک را برای شما آوردهام.
1.1 اگر پایتون 3 را بر روی کامپیوتر خود ندارید، آن را نصب کنید.
برای چگونگی اینکار به ضمیمه D
رجوع کنید.
1.2 مفسر محاورهای پایتون 3 را اجراء کنید. این برنامه چند خط که
مربوط به معرفی خودش است را روی صفحه نمایش میدهد، و سپس خطی نمایش داده میشود که با >>>
شروع میشود. این علامت نشان آمادگی پایتون برای
دریافت دستورات شما است.
1.3 کمی با مفسر بازی کنید. مانند یک ماشینحساب از آن استفاده کنید. مثلاً تایپ کنید 8*9 و دکمه Enter را فشار دهید. در
اینجا پایتون باید 72 را چاپ کند.
1.4 عدد 47 را تایپ کنید و دکمه Enter را فشار دهید.
آیا در خط بعدی 47 برای شما چاپ میشود؟
1.5 حالا تایپ کنیدprint(47)
و دکمه Enter را فشار دهید. آیا
باز هم در خط بعدی 47 برای شما چاپ میشود؟
فصل
2
اجزاء
پایتون: اعداد، رشتهها، و
متغیرها
در
این فصل ما نگاهی خواهیم افکند بر سادهترین گونههای ذاتی پایتون:
·
دادههای بولی ( که یا میتوانند True و یا False باشند)
·
اعداد صحیح (اعداد بدون ممیز،
مثل 42 یا 100000000)
·
اعداد ممیز شناور (اعدادی ممیز
دار، مثل 3.14159 یا 1.0e8)
·
رشتهها (دنبالهای از حروف متنی)
به
عبارتی، میتوان گفت که این گونهها به اتمها شباهت دارند، و ما در این فصل بصورت
انفرادی از آنها استفاده میکنیم. در فصل 3 نشان خواهیم داد که چگونه میتوان این اتمها را با هم ترکیب کرد و از آنها ”ملکولهای“ بزرگتری را ساخت.
کار با هر یک از این گونهها قواعد خاص خود را دارد و کامپیوتر نیز به طرق متفاوتی با آنها برخورد میکند. ما همچنین در این فصل متغیرها (variable)
را برای شما توضیح خواهیم
داد.
برنامههایی که در این فصل آمدهاند، همه برنامههای معتبر پایتون هستند، ولی آنها فقط تکههای کوچکی از برنامه هستند. ما از
مفسر محاورهای پایتون
استفاده میکنیم و این ”تکه برنامهها“ را وارد کرده و فوراً نتیجه آنها را مشاهده میکنیم. در فصل 4 شروع به نوشتن برنامههایی میکنیم که خودشان بتوانند اجراء شوند.
متغیرها،
نامها، و اشیاء
همه چیزها
در پایتون، از دادههای بولی گرفته تا اعداد صحیح، اعداد ممیز
شناور، رشتهها، ساختارهای دادهای بزرگ، توابع، و حتی خود برنامه، بعنوان یک شیء (object)
پیادهسازی میشود. این به زبان
پایتون ثبات و خواص مفیدی میدهد که زبانهای دیگر فاقد آن هستند.
یک
شیء شبیه
یک جعبه پلاستیکی شفاف است
که دادهای را در خود دارد (شکل2-1 ).
این شیء دارای یک گونه (type)
است که تعیین میکند چه کاری را میتوان با این داده انجام داد. گونه بولی، یا گونه صحیح، نمونههایی از گونههای ساده هستند. در دنیای واقعی، اگر روی
جعبهای برچسب ”سفالی“ خورده باشد، این چیزهای معینی را
به شما خواهد گفت (مثلاً اینکه این جعبه احتمالاً سنگین است، و باید آن را با
احتیاط حمل کنید). به طور مشابه در پایتون نیز اگر یک شیء گونه int داشته باشد، شما میدانید که میتوانید آنرا با int
دیگری جمع کنید.
شکل 1-2. یک شیء شبیه یک جعبه است
گونه یک شیء همچنین تعیین میکند که آیا مقدار دادهایی که شیء در بردارد قابل تغییر است (mutable)
یا ثابت (immutable).
شما میتوانید یک شیء غیرقابل تغییر را مانند یک
جعبه بسته در نظر بگیرید که دارای یک پنجره شفاف است: شما میتوانید داخل جعبه را ببینید ولی نمیتوانید آن را
تغییر دهید. بر همین قیاس، یک شیء قابل تغییر مانند جعبه بازی است که هم میتوانید داخل آن را ببینید و هم میتوانید محتوای آن
را تغییر دهید؛ ولی با اینحال نمیتوانید گونه آن را تغییر دهید.
پایتون
یک زبان قوی گونه (strongly typed)
است؛ یعنی هر چند مقدار یک شیء قابل
تغییر باشد،
ولی گونه شیء
ثابت و
غیر قابل تغییر میماند.
زبانهای
برنامهنویسی به شما اجازه میدهند تا متغیرهایی را تعریف کنید. متغیر نامی است که به مقادیری اشاره میکند که شما در
خانههای حافظه کامپیوتر تعریف کردهاید و میتوانید آنها را در برنامه خود بکار بگیرید.
در پایتون از علامت = برای نسبت دهی (assign)
یک مقدار به یک متغیر استفاده میشود.
همه ما در مدرسه یادگرفتهایم که علامت = به
معنای مساوی بودن است. پس چرا زبانهای برنامهنویسی، از جمله پایتون، از علامت =
برای نسبت دهی استفاده میکنند؟ یک دلیل این است که در صفحه کلید استاندارد هیچ کلیدی
دیگری وجود ندارد تا مثلاً بجای = از → استفاده کنیم، علامت = هم خیلی گیج کننده
نیست. همچنین شما در برنامههای کامپیوتری از عمل نسبت دهی خیلی بیشتر از عمل آزمون
تساوی دو مقدار استفاده میکنید.
در زیر دو خط برنامه به زبان پایتون دیده میشود که عدد صحیح 7
را در متغیری بنام a
قرار میدهد، و سپس مقدار فعلی نسبت داده شده به a را چاپ میکند:
>>> a =
7
>>> print(a)
7
حالا
وقت آن است که به نکته مهمی درباره متغیرها در زبان پایتون اشاره کنیم: متغیرها چیزی جز اسمها نیستند. نسبت دهی یک مقدار به یک متغیر باعث کپی شدن مقدار نمیشود؛ تنها کاری که انجام میشود این است که یک نام به شیئی متصل میشود که حاوی داده مربوطه است. این نام بیشتر از اینکه
حاوی خود شیء باشد،
تنها به آن اشاره (reference)
میکند. به متغیر تنها بعنوان برچسبی نگاه کنید که بر
روی شیء چسبیده است (به شکل 3-2 نگاه کنید).
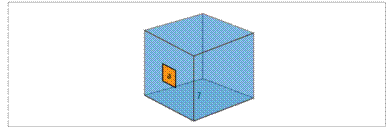
شکل 3-2. نامهایی که به یک
شیء چسبیدهاند
موارد
زیر را با مفسر محاورهای امتحان
کنید:
1.
مانند قبل مقدار 7
را به a نسبت دهید. این باعث
میشود تا شیئی بوجود آید که حاوی مقدار 7
است.
2.
مقدار a را چاپ کنید.
3.
a را به b نسبت دهید. این باعث میشود تا
بر روی جعبهای که حاوی 7 است، برچسب b
بخورد (علاوه بر برچسبی که قبلاً
داشت، یعنی a).
4.
مقدار b را چاپ کنید.
>>> a =
7
>>> print(a)
7
>>> b =
a
>>> print(b)
7
اگر
شما در پایتون بخواهید گونه چیزی
را مشخص کنید (یک متغیر، یا یک مقدار لفظی (literal))،
برای اینکار از (آن چیز)type استفاده کنید. بیایید تا گونه مقادیر لفظی مختلف (
مثل58 , 99.9 , abc )، و همچنین متغیرهای
مختلف (مثل a, b)،
را با استفاده از این روش تعیین کنیم:
>>>
type(a)
<class
'int'>
>>> type(b)
<class
'int'>
>>> type(58)
<class
'int'>
>>>
type(99.9)
<class 'float'>
>>> type('abc')
<class 'str'>
یک کلاس (class) تعریف دقیق یک شیء است؛ ما در فصل 6 کلاسها را با جزئیات بیشتری بررسی میکنیم. در پایتون”class“
و ”type“
تقریباً یک معنی را
میدهند.
اسامی
متغیرها فقط میتواند از حروف زیر تشکیل شود:
·
حروف کوچک (a تا z)
·
حروف بزرگ (A تا Z)
·
ارقام (0 تا 9)
·
حرف زیرینخط (Underscore) که بشکل ( _ ) است.
اسامی
نمیتوانند با یک رقم شروع شوند. همچنین پایتون با نامهایی که با زیرین خط شروع شوند بصورت خاصی برخورد میکند (که شما جزئیات آن را در فصل 4 مشاهده خواهید کرد). عبارات زیر نمونههایی از نامهای مجاز برای یک متغیر هستند:
• a
• a1
• a_b_c___95
• _abc
• _1a
ولی
اسامی زیر غیر مجاز هستند:
•
1
• 1a
• 1_
و
نهایتاً اینکه شما نباید از هیچ یک از اسامی زیر بعنوان نام متغیر خود استفاده کنید، زیرا اینها کلمات
رزرو شده (reserved
words) پایتون هستند که این زبان از آنها استفاده میکند.
|
return
try
while
with
yield
|
is
lambda
nonlocal
not
or
pass
raise
|
finally
for
from
global
if
import
in
|
class
continue
def
del
elif
else
except
|
False
None
True
and
as
assert
break
|
این
کلمات، و برخی از حروف نقطهگذاری، برای تعریف ”دستور زبان پایتون“ بکار میروند. شما در طول این کتاب با همه آنها آشنا خواهید شد.
اعداد
پایتون
بصورت ذاتی از اعداد صحیح و اعداد ممیز-شناور پشتیبانی میکند. با استفاده از عملگرهای (operators)
ریاضی، شما میتوانید عملیات ساده را بر روی این اعداد
انجام دهید:
عملگر
|
توضیح
|
مثال
|
حاصل
|
|
+
|
جمع
|
5+8
|
13
|
|
-
|
تفریق
|
90-10
|
80
|
|
*
|
ضرب
|
4*7
|
28
|
|
/
|
تقسیم ممیز شناور
|
7/2
|
3.5
|
|
//
|
تقسیم صحیح (گِرد شده)
|
7//2
|
3
|
|
%
|
باقیماندهگیری
|
7%3
|
1
|
|
**
|
توان
|
3**4
|
81
|
در صفحات
آتی من به شما نشان خواهم داد که چگونه میتوان از پایتون
بعنوان یک ”ماشین حساب بسیار عالی“ استفاده کرد.
...........................................
برای ادامه مطالعه این فصل نسخه کامل PDF کتاب را تهیه کنید.
فصل 3
لیستها، چندگانهها، دیکشنریها، و
مجموعهها
ما در فصل
2 کار خود
را با دادههای اساسی پایتون، یعنی اعداد، رشتهها، شناورها و دادههای بولی شروع کردیم. اگر شما آنها را مانند
اتمهای یک ماده فرض کنید، ما در این فصل به توضیح ملکولهایی که از این اتمها ساخته میشوند خواهیم پرداخت. این یعنی، ما اتمها را با هم
ترکیب میکنیم تا مواد پیچیدهتری بوجود آیند. شما همه روزه با این موارد
برخورد خواهید کرد. بیشتر کارهایی که در برنامهنویسی انجام میشود، شامل شکستن دادهها و چسباندن آنها به یکدیگر است تا اشکال بخصوصی از آنها حاصل شود.
لیستها و چندگانهها
بیشتر
زبانهای کامپیوتری میتوانند دنبالهای از اقلام را نمایش دهند که توسط مکان قرار گیری آنها ایندکس شدهاند: اولی، دومی،
و ... به همین ترتیب تا آخر. شما قبلاً با رشتههای پایتون، که دنبالهای از حروف هستند، آشنا شدید.
پایتون
دو ساختار دنبالهدار دیگر نیز دارد که عبارتند از: چندگانهها (tuples)
و لیستها (lists).
این ساختارها شامل صفر، و یا تعداد بیشتری، از اعضاء هستند. برخلاف رشتهها که
همه اعضای آن را حروف تشکیل میدهند، اعضای تشکیل دهنده یک چندگانه یا یک لیست میتوانند گونههای متفاوتی داشته باشند. درواقع هر یک
اعضاء میتواند هر شیئی از پایتون باشد. این به شما
اجازه میدهد تا ساختارهایی را ایجاد کنید که به هر
اندازه که بخواهید عمیق و پیچیده باشند. ولی چرا پایتون هم چندگانهها را در خود دارد و هم لیستها را؟ چندگانهها غیرقابل تغییر هستند؛ یعنی اگر عضوی را به یک چندگانه اضافه کنید، نمیتوانید بعداً آن را تغییر دهید. ولی لیستها قابل تغییر هستند، یعنی شما براحتی میتوانید اعضایی را در یک لیست درج، یا آنها را حذف کنید. با تکیه بر لیستها، من نمونههای زیادی را از هر دو اینها به شما نشان
خواهم داد.
لیستها
لیستها برای
مواردی مناسب هستند که بخواهیم رَد اشیاء را از روی ترتیب آنها دنبال کنیم،
مخصوصاً هنگامی که ممکن است ترتیب و محتوا تغییر کنند. برخلاف رشتهها، لیستها قابل تغییر هستند. شما میتوانید لیستها را درجا تغییر دهید، اعضای جدیدی را به
آنها اضافه کنید، و اعضای موجود را حذف کنید یا محتوای آنها را تغییر دهید. یک
مقدار میتواند چندین بار در یک لیست ظاهر شود.
یک لیست
از صفر، و یا تعداد بیشتری از اعضاء تشکیل شده که با کاما از یکدیگر جدا شده، و در
میان یک جف کروشه قرار گرفتهاند.
>>>
empty_list = [
]
>>>
weekdays = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
>>> big_birds
= ['emu', 'ostrich', 'cassowary']
>>> first_names
= ['Graham', 'John', 'Terry', 'Terry', 'Michael']
شما میتوانید توسط تابع list() یک لیست خالی را ایجاد کنید:
>>> another_empty_list
= list()
>>> another_empty_list
[]
ما بعداً در
بخش سازندهها نشان خواهیم داد که چگونه با استفاده از لیستسازها میتوانید یک لیست
را ایجاد کنید.
در اینجا weekdays تنها لیستی است که از
ترتیب اعضاء برخوردار است. لیست first_names نشان میدهد که اعضاء میتوانند تکراری نیز باشند.
درصورتی که فقط بخواهید رَد مقادیر یکتا (unique)
را دنبال کنید و ترتیب برای شما مهم نباشد، آنگاه ممکن است یک مجموعه (set)
بیشتر از یک لیست برای کار شما مناسب باشد. در مثال قبلی big_birds میتوانست یک مجموعه باشد. شما
در همین فصل با مجموعهها بیشتر آشنا خواهید شد.
تبدیل گونههای دیگر
به لیست با استفاده از تابع list()
تابع list() میتواند گونههای دیگر را به لیست تبدیل کند.
مثال بعدی یک رشته را به لیستی از رشتههای تک حرفی
تبدیل خواهد کرد:
>>>
list('cat')
['c', 'a', 't']
مثال
زیر یک چندگانه را
(که بعداً بیشتر در مورد آنها صحبت میکنیم) به یک لیست
تبدیل میکند:
>>> a_tuple = ('ready',
'fire', 'aim')
>>> list(a_tuple)
['ready', 'fire', 'aim']
همانطور
که قبلاً اشاره شد
تابع split() با گرفتن یک رشته جداکننده،
میتواند برای تقسیم کردن یک رشته به یک لیست بکار رود:
>>> birthday = '1/6/1952'
>>> birthday.split('/')
['1', '6', '1952']
خوب
حالا اگر در رشته اصلی شما چند جداکننده پشتسر هم ظاهر شوند، آنگاه وضعیت چگونه خواهد بود؟ خوب در اینجا شما یک رشته خالی
را خواهید داشت:
>>> splitme = 'a/b//c/d///e'
>>> splitme.split('/')
['a', 'b', '', 'c', 'd', '', '', 'e']
ولی
اگر جدا کننده شما رشته دو حرفی '//'
باشد، پس از فراخوانی split عبارت زیر را خواهید گرفت:
>>> splitme = 'a/b//c/d///e'
>>> splitme.split('//')
>>>
['a/b', 'c/d', '/e']
مانند
رشتهها، برای لیستها نیز
میتوانید یک مقدار تکی را با مشخص کردن آفسِت آن
بگیرید:
>>> marxes
= ['Groucho', 'Chico', 'Harpo']
>>> marxes[0]
'Groucho'
>>> marxes[1]
'Chico'
>>>
marxes[2]
'Harpo'
و
مشابه با رشتهها، اندیسهای منفی نیز بطور معکوس از آخر شمرده میشوند:
>>> marxes[-1]
'Harpo'
>>>
marxes[-2]
'Chico'
>>>
marxes[-3]
'Groucho'
>>>
در اینجا نیز آفسِت باید یک مقدار مجاز باشد.
اگر شما آفسِتی را مشخص کنید که به پیش از مبداء، و یا بعد از انتهای، یک لیست
اشاره کند، با یک اعتراض (یعنی خطا) مواجه خواهید شد. در زیر نشان داده شده اگر بخواهید ششمین عضو
لیست فوق (که آفسِت آن 5 است)، و یا عضوی که پیش از ابتدای لیست قرار دارد را
استخراج کنید، چه اتفاقی خواهد افتاد:
>>> marxes
= ['Groucho', 'Chico', 'Harpo']
>>> marxes[5]
Traceback
(most recent call last):
File "<stdin>", line 1, in <module>
IndexError:
list index out of range
>>>
marxes[-5]
Traceback
(most recent call last):
File "<stdin>", line 1, in <module>
IndexError:
list index out of
range
لیستها میتوانند حاوی گونههای مختلفی باشند، و همانطور که در زیر نشان
داده شده، آنها حتی میتوانند شامل لیستهای دیگر نیز باشند.
>>> small_birds
= ['hummingbird', 'finch']
>>> extinct_birds
= ['dodo', 'passenger pigeon',
'Norwegian Blue']
>>> carol_birds
= [3,
'French hens', 2, 'turtledoves']
>>> all_birds = [small_birds, extinct_birds, 'macaw', carol_birds]
بنابراین
لیست all_birds، که لیستی از چند لیست است،
چگونه بنظر خواهد آمد؟
>>> all_birds
[['hummingbird', 'finch'], ['dodo',
'passenger pigeon', 'Norwegian Blue'], 'macaw',
[3,
'French hens', 2, 'turtledoves']]
بیایید
به اولین عضو این لیست نگاهی بیاندازیم:
>>> all_birds[0]
['hummingbird', 'finch']
در
واقع اولین عضو لیست، خودش یک لیست است. این همان small_birds است که ما در ابتدای ایجاد all_birds
آن را مشخص کردیم. به همین ترتیب شما باید بتوانید حدس بزنید که دومین عضو این
لیست چیست:
>>> all_birds[1]
['dodo', 'passenger pigeon', 'Norwegian
Blue']
این
همان دومین مورد، یعنی extinct_birds، است که ما در ابتدای
ایجاد لیست all_birds آن را مشخص کرده
بودیم. اگر بخواهیم اولین عضو extinct_birds
را از all_birds استخراج کنیم، باید از دو اندیس استفاده
کنیم:
>>> all_birds[1][0]
'dodo'
[1] به دومین آیتم در all_birds
اشاره میکند، درحالی که [0]
به اولین عضو لیستی اشاره میکند که در داخل آن قرار دارد.
به همان
صورتی که میتوانید مقدار یک عضو را با مشخص کردن آفسِت
آن بگیرید، مقدار آن را نیز میتوانید تغییر دهید:
>>>
marxes = ['Groucho',
'Chico', 'Harpo']
>>> marxes[2] = 'Wanda'
>>>
marxes
['Groucho', 'Chico', 'Wanda']
بازهم
تکرار میکنم، آفسِت اعضاء باید معتبر باشند. بدلیل اینکه رشتهها غیر
قابل تغییرند، شما نمیتوانید حروف رشتههای یک لیست را تغییر دهید. ولی خود لیستها قابل
تغییرند و میتواند به هر اندازه که بخواهید اقلامی را در
آنها جای دهید، و یا هر یک از اقلام آنها را تغییر دهید.
با
استفاده از مکانیزم بُرش، که در مورد رشتهها به آن اشاره شد، شما میتوانید یک زیردنباله (subsequence)
را از یک لیست را استخراج کنید:
>>>
marxes = ['Groucho',
'Chico,' 'Harpo']
>>> marxes[0:2]
['Groucho', 'Chico']
یک
بُرش از لیست، خودش نیز یک لیست است. مانند رشتهها، برش لیستها نیز میتواند شامل گامی
غیر از 1 باشد. مثال بعدی از ابتدا شروع میکند و به تعداد 2 گام به سمت راست میرود:
>>> marxes[::2]
['Groucho', 'Harpo']
در
مثال بعد ما از انتها شروع میکنیم و 2 گام به سمت چپ میرویم:
>>> marxes[::-2]
['Harpo', 'Groucho']
و
بالاخره، ترفندی برای معکوس کردن یک لیست:
>>> marxes[::-1]
['Harpo', 'Chico', 'Groucho']
...........................................
برای ادامه مطالعه این فصل نسخه کامل PDF کتاب را تهیه کنید.
فصل
4
ساختار
برنامههای پایتون
شما در
فصلهای 1 الی 3 نمونههای زیادی از دادهها را مشاهده کردید، ولی کار زیادی با آنها انجام ندادید. بیشتر مثالهایی
که برای مفسر محاورهای آمده
کوتاه هستند. حالا شما نه فقط دادهها، بلکه ساختار برنامهها را نیز خواهید دید.
در
بسیاری از زبانهای برنامهنویسی از حروفی مانند آکولاد ({})،
و یا کلیدواژههایی (keywords)
نظیر begin وend برای بخشبندی برنامه
استفاده میشود. به منظور اینکه برنامهها هم برای خود شما و هم برای دیگران خواناتر شود، در اینگونه زبانها از تو
رفتگیهای (indentation)
یکدست استفاده میشود. حتی ابزارهایی وجود دارد که میتواند در کُدهای شما تورفتگیهای مناسب را ایجاد کند، تا از این نظر
برنامه
شما زیبا بنظر برسد.
هنگامی
که گیدو وَن روسوم (Guido van
Rossum) زبان پایتون را طراحی میکرد، او تصمیم گرفت که صرفِ ایجاد تورفتگی میتواند برای بخشبندی اجزاء مختلف برنامه کافی باشد، و از
بکارگیری حروف کروشه و دیگر کلیدواژهها صرفنظر کرد. از این لحاظ که پایتون برای تعریف ساختار برنامه از حروف
سفید (white
space) استفاده میکند، زبان
نامتعارفی محسوب میشود. این یکی از وجوه تمایز آن با زبانهای دیگر است که مبتدیان در نگاه اول متوجه آن میشوند، و اگر آنها با زبانهای دیگری کار کرده باشند، چنین چیزی برایشان عجیب است.
معلوم شده برنامه نویسان پس از مدتی که به پایتون برنامه مینویسند، اینکار برایشان عادی میشود و دیگر اهمیتی به آن نمیدهند. شما حتی به این عادت میکنید که با تایپ حروف کمتر، کارهای بیشتری
را انجام دهید.
توضیح گذاری با
#
توضیح (comment)
تکهای از متن است که شما در برنامههای خود میگذارید و مفسر پایتون آن را نادیده میگیرد. شما ممکن از توضیحات برای تشریح کُدهایی که در مجاور آنها قرار دارند
استفاده کنید، یا مثلاً برای خودتان یاداشتی بگذارید تا بعداً چیزی را اصلاح کنید،
و یا هرچیز دیگری که خودتان میدانید. شما میتوانید با قرار دادن علامت # شروع یک توضیح را
اعلان کنید؛
این یعنی هر چیزی که پس از علامت # بیاید، تا آخر خط از
آن بعنوان یک توضیح برداشت میشود. معمولاً توضیحات از ابتدای یک خط شروع
میشوند و تا آخر خط ادامه دارند:
>>>
# 60 sec/min * 60 min/hr * 24 hr/day
>>> seconds_per_day
= 86400
البته
توضیحات میتوانند در امتداد یک خط نیز ظاهر شوند:
>>> seconds_per_day = 86400 # 60 sec/min * 60 min/hr * 24 hr/day
حرف #
نامهای زیادی دارد، هَش (hash)،
شارپ (sharp)،
پاوند (pound)،
و یا از همه عجیبتر، اوکتوتروپ (octothorpe).
در هر صورت، نام آن هرچه باشد، تاثیرش فقط تا انتهای خطی است که در آن قرار دارد.
پایتون
چیزی بنام توضیحات چندخطی ندارد،
هر خطی را که شامل توضیحات است، باید صریحاً با # شروع شود:
>>>
# I can say anything here, even if Python doesn't like it,
...
# because I'm protected by the awesome
...
# octothorpe.
...
>>>
ولی
اگر حرف # در یک رشته قرار داشته باشد، در آنصورت قدرت خود را از
دست میدهد و فقط در نقش یک حرف ساده عمل میکند:
>>> print("No comment: quotes make the #
harmless.")
No
comment: quotes make the # harmless.
ادامه
خطوط با \
وقتی خطوط
کوتاهتر باشند، برنامهها نیز خواناتر میشوند. حداکثر طول توصیه شده برای یک خط (که
البته الزامی هم نیست) 80 حرف است. اگر شما نمیتوانید کار مورد
نظر خود را در این طول بگنجانید، در پایان خط خود یک حرف
ادامه خط
(\) بگذارید. در این صورت پایتون طوری عمل میکند که انگار خط بعدی ادامه خط فعلی است. برای مثال، فرض کنید من میخواهم از
چند رشته کوچک یک رشته بلند بسازم. من میتوانم اینکار را به روش زیر انجام دهم:
>>>
alphabet = ''
>>> alphabet
+= 'abcdefg'
>>> alphabet
+= 'hijklmnop'
>>> alphabet += 'qrstuv'
>>>
alphabet += 'wxyz'
و
یا میتوانم با استفاده از حرف ادامه خط، کلیه اینکارها را در یک مرحله انجام دهم:
>>> alphabet = 'abcdefg' + \
... 'hijklmnop'
+ \
...
'qrstuv' + \
... 'wxyz'
همچنین
درصورتی که عبارتهای پایتون در چندین خط تایپ شوند، به حرف ادامه نیاز خواهد بود. برای نمونه، عبارت زیر که
قرار است بر روی 2 خط تایپ شود را در نظر بگیرید:
>>> 1 +
2 +
File
"<stdin>", line 1
1 + 2 +
^
SyntaxError:
invalid syntax
ولی
اگر در پایان خط \ بگذارید هیچ
مشکلی نخواهد بود:
>>>
1 + 2 + \
... 3
6
>>>
مقایسه
عبارات با if، elif، و else
تا
اینجای کتاب ما تقریباً فقط در مورد ساختار دادهها صحبت کردهایم. ولی حالا میخواهیم اولین قدمها را در آشنایی با ساختار برنامه برداریم،
ساختارهایی که دادهها را به برنامه میبافد. (البته شما قبلاً بصورت زودگذر برخی از این ساختارها را دیدهاید.) اولین مثال ما، یک برنامه کوچک پایتون است که مقدار یک متغیر بولی بنام disaster
را بررسی میکند و توضیح مناسبی را برای آن چاپ میکند:
>>> disaster = True
>>> if disaster:
...
print("Woe!")
...
else:
... print("Whee!")
...
Woe!
>>>
If و else دستوراتی هستند که درستی یک شرط را بررسی میکنند (در اینجا مقدار متغیر disaster را بررسی میکنند). بخاطر داشته باشید که print()
یک دستور نیست،
بلکه یکی از توابع پیشساخته پایتون است که برای شما چیزهایی را چاپ میکند
(معمولاً بر روی صفحه نمایش).
درصورتی که به زبانهای دیگری برنامهنویسی کرده باشید،
متوجه میشوید که نیازی نیست تا پس از if پرانتز بگذارید. مثلاً نیازی
نیست بگوئید if (disaster== True). البته لازم است در انتهای خط
if یک علامت : بگذارید، در غیراینصورت با یک اعتراض پایتون مواجه میشوید.
در خطوطی
که پس از if یا else آمده،
خطوط دارای فرو رفتگی هستند. من برای فرورفتگی از چهار فاصله استفاده کردهام. هرچند که شما میتوانید به هر مقدار که بخواهید تورفتگی ایجاد
کنید، ولی پایتون از شما انتظار دارد که کلیه تورفتگیهای یک بخش همه به یک میزان باشند و کلیه خطوطِ بخش از سمت چپ با هم تراز
باشند. سبکی که پیروی از آن توصیه شده PEP-8k نامیده میشود و در آن برای ایجاد تورفتگی از چهار حرف فاصله استفاده میشود. برای ایجاد تورفتگی، از حرف جدول استفاده نکنید. همچنین حروف جدول را با
حرف فاصله باهم مخلوط نکنید، زیرا اینکار باعث اختلال در شمارش فرورفتگی میشود.
در
مثال فوق ما چندین کار انجام
دادیم که من آنها را بصورت کامل فهرست میکنم:
·
یک مقدار صحیح بولی را به متغییری
بنام disaster نسبت دادیم
·
با استفاده از دستورات if و else یک
مقایسه شرطی را انجام دادیم و بسته به اینکه مقدار disaster چه باشد، کُد
متفاوتی را اجراء کردیم
·
تابع print() را فراخوانی (Call)
کردیم تا متنی را
برای ما چاپ کند
شما
میتوانید به هر اندازه که بخواهید در درون یک if، بصورت تو در تو ifهای دیگری داشته باشید:
>>> furry
= True
>>> small
= True
>>>
if furry:
... if small:
...
print("It's
a cat.")
... else:
...
print("It's
a bear!")
...
else:
...
if small:
...
print("It's
a skink!")
...
else:
...
print("It's
a human. Or a hairless bear.")
...
It's a cat.
در
پایتون این تورفتگیها هستند که تعیین میکنند چگونه بخشهای if
و else با هم
جور شوند. در اولین if،
ما مقدار furry را بررسی میکردیم. بدلیل اینکه furry صحیح است، پایتون
تورفتگی if small را دنبال میکند. بدلیل اینکه ما مقدار small را True قرار دادهایم، if small نیز صحیح برآورده میشود. این باعث میشود تا پایتون 'It's a cat' را چاپ کند. اگر تعداد چیزهایی که باید بررسی
شود از دو تا بیشتر بود، از if،
elif، و else استفاده کنید.
>>>
color = "puce"
>>> if color ==
"red":
...
print("It's
a tomato")
... elif color ==
"green":
...
print("It's
a green pepper")
...
elif color == "bee
purple":
... print("I
don't know what it is, but only bees can see it")
...
else:
... print("I've
never heard of the color", color)
...
I've never heard of the color puce
...........................................
برای ادامه مطالعه این فصل نسخه
کامل PDF کتاب را تهیه کنید.
فصل 5
ماجولها، پکیجها و برنامهها
تا اینجا،
شما کار خود
را از گونههای پیشساخته پایتون
شروع کردید و به گونهها و سازههای بزرگتر رسیدید. در این فصل بالاخره به مرحلهای رسیدهاید که یادبگیرید چگونه یک برنامه بزرگ و
واقعی پایتون نوشته میشود.
برنامههای خودکفا
شما قبلاً
برنامههای کوچکی نظیر زیر را در مفسر محاورهای نوشته
و اجرا میکردید:
>>>
print("This
interactive snippet works.")
This
interactive snippet works.
حالا
بیایید تا نخستین برنامه خودکفای خودمان را بسازیم. در کامپیوترتان فایلی بنام test1.py
را ایجاد کنید که حاوی تک خط زیر باشد:
print("This
standalone program works!")
توجه کنید
که در اینجا دیگر خبری از علامت اعلام آمادگی پایتون (یعنی >>>)
نیست، و این فایل تنها حاوی یک خط است که یک دستور پایتون در آن قرار دارد. مطمئن شوید که قبل
از print هیچ گونه تورفتگی وجود نداشته باشد.
اگر
پایتون را در یک ترمینال متنی اجراء
میکنید، نام برنامه اجرایی پایتون، و بدنبال آن نام
فایل ایجاد شده، را تایپ کنید:
$ python
test1.py
This
standalone program works!
شما قبلاً برنامههای کوچک خود را در
مفسر محاورهای اجراء میکردید، حالا میتوانید آنها را در فایلی ذخیره کرده و مستقیماً اجراء کنید. اگر از copy و paste استفاده میکنید، باید مراقب
باشید که کلیه >>>ها و ...ها را حذف کنید.
آرگومانهای خط فرمان
در
کامپیوتر خود فایلی بنام test2.py را ایجاد کنید که حاوی دو خط زیر باشد:
import
sys
print('Program arguments:', sys.argv)
حالا
از پایتون برای اجرای این برنامه استفاده کنید. مثلاً در لینوکس، یا ویندوز یک
ترمینال باز کرده و دستورات زیر را در آن تایپ کنید:
$ python
test2.py
Program
arguments: ['test2.py']
$ python
test2.py tra la la
Program arguments: ['test2.py', 'tra', 'la', 'la']
ماجولها و دستور import
حالا ما
سطح دیگری را پیریزی میکنیم، بصورتی که از برنامههایی که قبلاً نوشتهایم، در چندین برنامه استفاده کنیم. یک ماجول (module)
چیزی نیست جز یک فایل پایتون.
متن
این کتاب سلسلهمراتبی دارد: لغات، جملهها، پاراگرافها، بخشها، و فصلها. در غیر اینصورت، کتاب پس از یکی دو صفحه
غیرقابل خواندن میشد. برنامهها نیز تقریباً سازماندهی
بالا-به-پایین مشابهی دارند: دادهها مانند لغات هستند، دستورات شبیه جملات،
توابع مانند پاراگرافها، و ماجولها شبیه فصلها. اگر بخواهیم این مقایسه را ادامه دهیم،
مثلاً وقتی میگوییم ”مطلبی در فصل 8 قرار دارد و شما میتوانید به آن رجوع کنید“،
این در برنامهنویسی پایتون شبیه این است که بگویم ”چیزی در ماجول دیگری قرار دارد و شما میتوانید به آن رجوع
کنید“.
ما
برای رجوع به دستوراتی که در ماجولهای دیگر قرار دارند از دستور import استفاده میکنیم. این باعث میشود تا دستورات و متغیرهایی که در آن ماجولها قرار دارند برای برنامه شما نیز قابل دسترس شوند.
سادهترین شکل استفاده از import به این صورت است:
import module
که
دراینجا module نامِ
فایلِ پایتون مورد نظر، بدون ذکر پسوند py، است. بیایید یک ایستگاه
هواشناسی را شبیهسازی کنیم و یک گزارش آب و هوایی را چاپ کنیم. خودِ گزارش در
برنامه اصلی چاپ میشود، ولی شرح وضعیت آب و هوا از ماجول جداگانهای که حاوی یک تابع است، بازگردانده میشود.
برنامه
اصلی (که ما آن را weatherman.py مینامیم) به صورت زیر است:
import
report
description
= report.get_description()
print("Today's weather:", description)
و
ماجول report (که در فایل report.py
ذخیره شده) به این صورت است:
def get_description(): #
see the docstring below?
"""Return
random weather, just like the pros"""
from random import choice
possibilities
= ['rain', 'snow', 'sleet', 'fog', 'sun', 'who knows']
return choice(possibilities)
درصورتی
که این دو فایل هر دو در یک دایرکتوری ذخیره شده باشند و شما به پایتون دستور دهید تا برنامه اصلی weatherman.py
را اجراء کند، برنامه ماجول report
را مورد دسترس قرار میدهد و تابع get_descrip() را اجراء میکند. ما این نسخه از get_descrip()
را به صورتی نوشتیم که یک نتیجه تصادفی را بازگرداند که از لیستی از رشتهها انتخاب
شده است. بنابراین آنچه برنامه اصلی نیز چاپ میکند، همین موارد است:
$ python weatherman.py
Today's weather: who knows
$ python
weatherman.py
Today's weather: sun
$ python
weatherman.py
Today's weather: sleet
ما
در دو جا از import
استفاده کردیم:
· در برنامه اصلی weatherman.py
ماجول report را به برنامه وارد کردیم (import=وارد کردن).
·
در فایل ماجول report.py،
تابع get_description() از ماجول استاندارد random
تابع choice
را وارد کردیم.
همچنین
به دو روش مختلف از آنچه وارد شده بود استفاده کردیم:
·
برنامه اصلی دستور import report را صادر، و سپس report.get_descrip() را اجراء کرد.
·
در ماجول report.py، تابعِ get_descrip() از ماجول random تابعِ choice را وارد، و سپس دستور choice(possibilities)
را اجرا کرد.
در
مورد نخست ما برای استفاده از تابع get_description()، کُل ماجول report را به برنامه خود
وارد کردیم. در اینحالت، کُل چیزهایی که در report.py
قرار دارند برای برنامه اصلی قابل دسترس میشوند، البته
بشرطی که قبل از چیزی که میخواهیم به آن رجوع کنیم یک “report.” بگذاریم. با تعیین دقیق
محتوای مورد نظر (با ذکر نام ماجول و یک نقطه)، ما از هرگونه تضادی که ممکن است در
نامهای یکسان وجود داشته باشد پرهیز میکنیم. ممکن است یک get_description()
دیگری نیز در ماجولهای دیگر وجود داشته باشد، ولی ما قبل از آن
یک “report.” میگذاریم تا به پایتون بگوییم منظور ما همان get_description() است که در ماجول report قرار دارد.
در
مورد دوم، ما در درون یک تابع هستیم و میدانیم در اینجا
چیز دیگری وجود ندارد که نام آن choice باشد، پس ما مستقیماً از داخل ماجول random، تابع choice را وارد میکنیم. البته میتوانیم تابع را بصورت زیر نیز تعریف کنیم،
که بازهم نتیجه مانند قبل خواهد بود:
def get_description():
import random
possibilities = ['rain', 'snow', 'sleet', 'fog', 'sun', 'who
knows']
return random.choice(possibilities)
مانند
بسیاری از جنبههای دیگر برنامه نویسی، از سبکی که برایتان
روشنتر و راحتتر استفاده کنید. استفاده از random.choice ایمنتر است، ولی به تایپ بیشتری نیاز دارد.
مثالهایی
که در مورد get_description() بیان شد نشان میدهد که چه چیزی را وارد کنیم، ولی نشان نمیدهد که کار وارد
کردن را در کجا باید انجام دهیم (در همه آنها import در داخل تابع انجام گرفته
است). ولی ما میتوانستیم random را خارج
از تابع نیز import
کنیم:
>>>
import random
>>>
def get_description():
...
possibilities = ['rain', 'snow', 'sleet', 'fog', 'sun', 'who knows']
...
return random.choice(possibilities)
...
>>>
get_description()
'who
knows'
>>> get_description()
'rain'
اگر
از ماجول وارد
شده (import شده) در بیش از یکجا
استفاده میشود، باید دستور import را خارج از تابع بکار
ببرید تا مجبور نباشید آن را تکرار کنید.
برخی ترجیح میدهند تا ماجولها را در بالای فایل وارد کنند، که این باعث
میشود از همان ابتدا هرگونه وابستگی که به این ماجولها وجود دارد رفع شود. هر دو این روشها جواب میدهند.
...........................................
برای ادامه مطالعه این فصل نسخه کامل PDF کتاب را تهیه کنید.
فصل 6
اشیاء و
کلاسها
تا اینجا
شما با ساختارهای دادهای مثل: رشتهها و
دیکشنریها، و همچنین با ساختارهای برنامهایی مثل: توابع و ماجولها آشنا شدید. در این فصل با ساختارهای دادهیی سفارشی آشنا خواهید شد که شیء (Objects)
نام دارند.
اشیاء
چیستند؟
در فصل 2
اشاره کردم
که همه چیز در پایتون، از اعداد گرفته تا ماجولها، همه برای خودشان یک شیء هستند.
بسیاری از سازکارهای پیچیدهای که یک شیء میتواند داشته باشد توسط پایتون از دید شما پنهان میشود. برای مثال، شما برای ایجاد شیئی بنام num، که از نوع صحیح است، و نسبت
دادن عدد 7 به آن، تنها کافی است تایپ کنید num = 7. فقط وقتی لازم است
به درون یک شیء نگاه کنید که خودتان بخواهید یک شیء جدید را ایجاد کنید و یا رفتار
اشیاء موجود را تغییر دهید. در این فصل شما چگونگی انجام هر دو اینها را یاد
خواهید گرفت.
یک
شیء هم
دادههایی را دربردارد (همان متغیرهایی که خاصه attribute نامیده میشوند)، و هم شامل
دستورات است (همان توابعی که متد method نامیده میشوند). یک شیء
نمایانگرِ منحصر بفردِ
یک چیز واقعی است. برای مثال، شیء صحیحی که مقدار آن 7 است، شیئی است
که مِتُدهایی نظیر جمع و ضرب را آسان میکند. هر چند عدد 8 شیء متفاوتی است، ولی در
پایتون هم 7 و هم 8، هر دو به کلاس اعداد صحیح تعلق دارند. رشتههای'cat' و 'duck'نیز در پایتون شیء هستند، و برای خودشان
متدهای خاصی همچون capitalize()
و replace() دارند.
اگر
بخواهید اشیاء جدیدی را ایجاد کنید که قبلاً کسی آنها را ایجاد نکرده،
باید کلاسی را ایجاد کنید که نشان دهد این اشیاء حاوی چه چیزهایی هستند.
اشیاء
را همچون اسامی، و متدهای آنها را همچون افعال در نظر بگیرید. یک شیء نشانگر یک چیز منحصر بفرد است، و متدهای آن
چگونگی تعامل آن چیز با دیگر چیزها را تعریف میکنند.
برخلاف
ماجولها، شما میتوانید همزمان
اشیاء مختلفی را داشته باشید که مقدار خاصههای هر کدام از
آنها متفاوت باشند. آنها شبیه اَبَرساختمانهای دادهای هستند که دستوراتی هم در آنها گنجانده شده.
تعریف
یک کلاس تو سط class
در فصل 1
من یک شیء را
با یک جعبه پلاستیکی مقایسه کردم. کلاس قالبی است که جعبه را میسازد. برای نمونه، String
یکی از کلاسهای پیشساخته پایتون است که اشیاء رشتهای، مثل'cat' و 'duck'،
را میسازد. پایتون
حاوی بسیاری از کلاسهای پیشساخته است که برای ایجاد گونههای استاندارد دیگر (مثل لیستها، دیکشنریها، و غیره) از آنها استفاده میشود. در پایتون برای ایجاد اشیاء سفارشی خودتان، ابتدا لازم است با استفاده از
کلیدواژه class
یک کلاس را تعریف کنید. بیایید تا این موضوع را با استفاده از یک مثال ساده دنبال
کنیم.
فرض
کنید بخواهید اشیایی را تعریف کنید که نمایانگر اطلاعاتی درباره اشخاص باشد. هر
شیء یک
شخص را نمایندگی میکند. شما ابتدا باید کلاسی بنام Person را بعنوان قالبی برای
این شیء تعریف کنید. در مثالهای زیر ما سعی خواهیم کرد تا چند نسخه از این کلاس ارائه دهیم. کار خود را از کلاسهای ساده شروع میکنیم تا به نمونههای واقعیتر برسیم.
کار خود را با سادهترین کلاس ممکن،
یعنی یک کلاس تُهی، شروع میکنیم:
>>>
class Person():
... pass
برای
اینکه مشخص کنیم این کلاس خالی
است، در اینجا نیز مانند توابع، نیاز داریم تا pass را ذکر کنیم. این تعریف حداقل
چیزی است که توسط آن میتوان یک شیء را
ایجاد کرد. شما با ذکر نام کلاس میتوانید شیئی از آن را ایجاد کنید، درست مثل
اینکه کلاس یک تابع باشد:
>>> someone
= Person()
در این
مثال، Person()
یک شیء منفرد
از کلاس Person
را ایجاد کرده و آن را به someone نسبت میدهد. ولی کلاس Person
ما خالی است، پس شیء someone که از روی آن ساخت شده نمیتواند کار بخصوصی را انجام دهد. در واقع شما هرگز چنین کلاسی
را ایجاد نمیکنید، من این را فقط محض نمونه ذکر کردم تا
به مثال بعدی برسم.
بیایید
تا کلاس Person
را دوباره تعریف کنیم، ولی این بار متد خاصی بنام __init__
را در آن میگنجانیم که وظیفه آن دادن مقادیر اولیه است:
>>>
class Person():
... def __init__(self):
... pass
مثال
فوق چیزی است که در همه تعاریف یک کلاس واقعی دیده میشود. من قبول دارم که چیزهایی مانند __init__() و self عجیب بنظر میرسند. ولی __init__() مِتُد خاصی در پایتون
است که وظیفه آن مقدار دهی اولیه به یک شیء، براساس تعریف کلاس آن است. آرگومان self به خود شیء اشاره میکند.
هنگامی که
در تعریف یک کلاس از
__init__() استفاده میکنید، اولین پارامتر آن
باید self باشد. هرچند self
یکی از لغات رزرو شده پایتون نیست،
ولی کاربرد آن در اینمورد بسیار متداول است. self نام مناسبی نیز هست
زیرا به خود دلالت میکند و هر کس برنامه شما را بعداً بخواند میفهمد که منظورتان چیست.
با
اینحال، در تعریف دومی هم که برای Person
کردیم، حقیقتاً هنوز هم شیئی ایجاد نمیشود که کار بخصوصی را انجام دهد. ما در مثال سوم سعی میکنیم شیء سادهای را در پایتون ایجاد کنیم. ما اینبار پارامتری بنام name را به متد مقدار دهنده اضافه
میکنیم:
>>>
class Person():
... def __init__(self, name):
...
self.name =
name
...
>>>
حالا
میتوانیم با فرستادن یک رشته برای name،
از روی کلاس Person
یک شیء ایجاد
کنیم:
>>> hunter = Person('Elmer Fudd')
کاری که
این خط از برنامه انجام میدهد عبارت است از:
·
به تعریف کلاس Person رجوع میکند
·
شیء جدید را در حافظه نمونهسازی (Instantiate) میکند (ایجاد میکند).
·
متد __init__
کلاس را
فراخوانی کرده،
و این شیء تازه
ایجاد شده را بعنوان آرگومان self،
و رشته 'Elmer Fudd' را بعنوان آرگومان name به این متد میفرستد.
·
مقدار name را در شیء ذخیره میکند.
· نام hunter
را به شیء نسبت
میدهد.
این
شیء جدید
شبیه بقیه اشیاء دیگر در پایتون است. شما میتوانید از آن بعنوان یکی از عضوهای یک لیست، یک چندگانه، و یا یک مجموعه استفاده کنید. میتوانید آن را بعنوان آرگومان به
یک تابع بفرستید، و یا آن را بعنوان نتیجه تابع بازگردانید.
خوب
تکلیف مقدار name
چه میشود؟ این بعنوان یکی از خاصههای کلاس Person
در شیء ذخیره
شده است. شما میتوانید مستقیماً آن را بخوانید و یا
بنویسید:
>>>
print('The
mighty hunter: ', hunter.name)
The
mighty hunter: Elmer Fudd
بخاطر
داشته باشد که وقتی بخواهید در داخل تعریف کلاس Person به خاصه name رجوع کنید از آن بصورت self.name رجوع میکنید. ولی وقتی از روی این کلاس یک شیء واقعی، مانند hunter ساخته شد، به این خاصه به شکل
hunter.name رجوع میکنید.
لزومی
ندارد در تعریف هر کلاسی
متد __init__ داشته باشید؛ از __init__
برای این استفاده میشود که در داخل آن کارهایی انجام گیرند که
لازم است اشیاء ساخته شده از این کلاس را از یکدیگر متمایز کند.
وراثت
هنگامی که
شما با امور نرمافزاری سروکار دارید، غالباً درمییابید که کلاسی وجود دارد که کار مورد نظر شما را تقریباً انجام میدهد (ولی نه دقیقاً). چه باید کرد تا این کلاس دقیقاً همان کاری را که میخواهید انجام دهد ؟ یک گزینه ممکن این است که متناسب با نیاز خود تعریف کلاس
قدیمی را تغییر دهید، ولی این اوضاع را پیچیدهتر میکند و در این راه ممکن شما چیزی که قبلاً
درست کار میکرده را خراب کنید!
البته
میتوانید با کپی گرفتن و چسباندن (copy
and paste) کُدهای کلاس قدیم و ادغام آن در برنامه خودتان، کلاس جدیدی را
تعریف کنید. ولی این یعنی شما مجبورید تا از کُدهای بیشتری نگهداری کنید، و
بخشهایی از کلاسهای جدید و قدیم که قبلاً درست کار میکردند ممکن است
کمکم از هم فاصله بگیرند.
راه
حل این مسئله استفاده از وراثت (inheritance)
است. وراثت یعنی ایجاد کلاسهای جدید از کلاسهای موجود، بدون تغییر این کلاسها، و تنها با اضافه نمودن موارد جدید به آنها.
این روش بسیار خوبی برای کاهش حجم کُدها است. وقتی شما از وراثت استفاده میکنید، کلاس جدید
میتواند بصورت خودکار از تمام کُدهای کلاس قدیم
استفاده کند، بدون آنکه نیازی به کپی کردن آنها باشد.
در
وراثت فقط
آن چیزهایی به کلاس جدید
اضافه میشود، یا تغییر پیدا میکنند، که به آنها نیاز باشد، و درست در همین موارد است که رفتار کلاس قدیم
بازنویسی شده و رفتارهای مورد نظر برای آن تعریف میشود. اصطلاحات مختلفی برای کلاس قدیمی وجود دارد، نامهای از قبیل: کلاس
والد (parent)
یا ابرکلاس (superclass)،
و یا کلاسپایه (base class). همچنین از کلاس جدید نیز با نامهایی مثل: کلاس فرزند (child
class)، زیرکلاس (subclass)،
و یا کلاس منشعب (derived class)
نام برده میشود. کلیه این اصطلاحات در حوزه برنامهنوسی شیءگرا متداول هستند و میتوان از آنها استفاده کرد.
خوب
حالا بیاید از وراثت استفاده
کنیم و چیزی را به ارث ببریم. ما یک کلاس خالی بنام Car را تعریف میکنیم. سپس
زیرکلاسی از Car
بنام Yugo را تعریف خواهیم کرد.
شما برای تعریف یک زیرکلاس نیز
باید از کلید واژه class استفاده کنید، با این تفاوت که نام کلاس والد را در پرانتز ذکر میکنید (مثلاً مینویسید: class Yugo(Car)).
>>>
class Car():
... pass
...
>>>
class Yugo(Car):
... pass
...
سپس
یک شیء از
هر دو کلاس ایجاد
میکنید:
>>> give_me_a_car = Car()
>>> give_me_a_yugo
= Yugo()
...........................................
برای ادامه مطالعه این فصل نسخه کامل PDF کتاب را تهیه کنید.
فصل 7
کار کردن با
دادهها بصورت حرفهای
شما
در این فصل برای به نظم درآوردن دادهها با تکنیکهای فراوانی آشنا خواهید شد. بیشتر
اینها مربوط به گونههای پیش-ساخته پایتون است، گونههایی از قبیل:
·
رشتهها (strings)،
که دنبالهای از حروف یونیکد (Unicode)
هستند، و از آنها برای دادههای متنی (text)
استفاده میشود.
·
بایتها
و آرایههای بایتی، که دنبالهای
از اعداد 8-بیتی هستند، و برای دادههای
باینری از آنها استفاده میشود.
رشتههای متنی
رشتههای متنی برای
اغلب خوانندگان بسیار آشنا هستند، بنابراین ما کار خود را با برخی ویژگیهای رشتههای متنی در پایتون شروع میکنیم.
کلیه متون
این کتاب از استاندارد اسکی (ASCII)
پیروی میکند. در دهه 1960، درست در زمانی که کامپیوترها
به اندازه یخچالهای بزرگ بودند، و کار آنها عمدتاً محاسبه بود، استاندارد اسکی نیز تدوین
شد. واحد اصلی اندازهگیری ذخیره داده بایت (byte)
نام دارد، که خود از 8 بیت تشکیل شده و میتواند 256 مقدار
مختلف را در خود جای دهد. به دلایل مختلف، استاندارد اسکی تنها میتواند از 7 بیت استفاده کند (یعنی نصف یک بایت، و معادل با 128 مقدار مختلف). از این 128 مقدار مختلف
میتوان برای ذخیره 26 حرف کوچک، 26 حرف بزرگ، 10 رقم 0
الی 9، برخی از حروف نقطه گذاری، برخی از حروف فاصله گذاری، و
نهایتاً برخی از حروف کنترلی (که غیرقابل نمایش هستند) استفاده کرد.
اگر
کلیه زبانهای انسانی را باهم درنظر بگیریم، متاسفانه
حروف بسیار بیشتری از آنچه ASCII ارائه کرده، وجود دارند. برای مثال، شما با استفاده
از حروفASCII حتی قادر به نمایش همه لغات زبانهای اروپایی مثل
آلمانی و فرانسوی هم نیستید (لغاتی مثل Gewürztraminer و café). به همین منظور تلاشهای بسیاری انجام گرفت تا استانداردهایی وضع شود که در آنها حروف و علائم
بیشتری وجود دارند. شما بعداً با بعضی از این استانداردها آشنا خواهید شد. برخی از
آنها عبارتند از:
·
Latin-1 که ISO 8859-1 نیز نامیده میشود.
· Windows
code page 1252.
در این
استانداردهای جدید از تمامی 8 بیت استفاده میشد، و میتوانست 256 حرف مختلف را نمایش دهد. ولی حتی
این هم برای نمایش همه حروف مورد نیاز کافی نبود، علیالخصوص زمانی که نیاز داشته باشید حروف زبانهای غیر-اروپایی را نمایش دهید
(چینی، هندی، عربی ...). یونیکُد یک استاندارد بینالمللی درحال پیشرفت است که برای تعریف کلیه حروف زبانهای دنیا، و نیز نمادهایی
که در ریاضیات و حوزههای دیگر کاربرد دارند، از آن استفاده میشود. متن زیر توضیح کوتاهی
برای استاندارد یونی کد است:
”صرف
نظر از اینکه که حروف در کجا، در چه برنامه، و در چه زبانی بکار گرفته میشوند، استاندارد یونیکد برای هر حرف یک عدد (یا بعبارتی یک کُد) منحصر بفرد
را اختصاص میدهد.“
کنسرسیوم یونیکد
یک صفحه
اینترنتی وجود دارد (http://www.unicode.org/charts)
که کلیه حروف یونیکد، و نیز تصاویر آنها، را در بر دارد. در
آخرین نسخه این استاندارد (نسخه 6.2)، بیش از 110 هزار حرف تعریف شده که هر کدام
نام، و شماره شناسایی منحصر بفرد، خود را دارند. این حروف در دستههای 8-بیتی تقسم بندی شدهاند که به آنها پلان (plane)
گفته میشود. 256 پلان اول به پلان
چندزبانه اصلی (basic
multilingual planes) شناخته میشود.
رشتههای حرفی
یونیکد در پایتون 3
در پایتون
3، رشتهها از نوع یونیکد هستند، و نه آرایهای از بایتها. این مهمترین تغییری است که در گذار از پایتون 2
به پایتون 3 حاصل شده. در اینجا بین رشتههای متشکل از بایت، و رشتهها متشکل از حروف یونیکُد تمایزی وجود دارد.
اگر
شما نام، و یا شناسه (ID)
حرف یونیکُد مورد نظر خود را بدانید، میتوانید از آن در رشتههای یونیکد پایتون
استفاده کنید. در زیر چند نمونه از آنها را میبینید:
·
برای مشخص کردن یک حرف در یکی
از این 256 پلان چندزبانه
اصلی، میتوانید بدنبال \u چهار عدد هگز را ذکر کنید که مشخص کننده کُد حرف مورد نظر
است. دو عدد اول نشاندهنده شماره پلان (00 الی FF)،
و دو عدد بعدی نمایانگر اندیس حرف در خود پلان هستند. پلان00 همان استاندارد قدیمی ASCII است، و
مکان قرارگیری حروف در آن با کدهای ASCII
مطابقت دارد.
·
برای نمایش حروفی که در پلانهای بالاتر قرار دارند (از پلان 256
به بالا) به بیتهای بیشتری نیاز است. پایتون برای مشخص کردن
چنین حروفی از هشت حرف هگز استفاده
میکند که بدنبال زنجیره گریز \U میآید، و حرف سمت چپی باید 0 باشد.
·
روش دیگری که میتوانید از آن برای مشخص کردن حروف یونیکد استفاده کنید، ذکر نام استاندارد حرف مورد
نظر است. در اینجا برای مشخص کردن حرف از دنباله \N{ name } استفاده
میکنید. که name نام حرف است. اگر میخواهید اسامی حروف یونیکد را بدانید، میتوانید به صفحه مربوطه رجوع کنید.
در
پایتون ماجول unicodedata
دارای توابعی است که میتوانید برای کار با حرف یونیکد از
آنها استفاده کنید. مثلاً در میان آنها:
·
تابع lookup() نامی را که به حروف کوچک و بزرگ حساس نیست گرفته و حرف یونیکد مربوط
به آن را بازمیگرداند.
·
تابع name()
یک حرف یونیکد را گرفته و نام آن را برای شما بازمیگرداند.
در
مثال بعد، ما یک تابع آزمایشی را تعریف میکنیم که یک حرف
یونیکد پایتون
میگیرد، نام آن را پیدا میکند، و بر اساس نام یافت شده دوباره حرف یونی را پیدا میکند (که باید با حرف اولیه مطابق باشد):
>>>
def unicode_test(value):
... import unicodedata
...
name = unicodedata.name(value)
...
value2 = unicodedata.lookup(name)
...
print('value="%s", name="%s",
value2="%s"' % (value,
name, value2))
...
بیایید
این تابع را برای چند حرف مورد آزمایش قرار دهیم:
>>> unicode_test('A')
value="A",
name="LATIN
CAPITAL LETTER A", value2="A"
حرف
$:
>>> unicode_test('$')
value="$",
name="DOLLAR
SIGN", value2="$"
حرف
یونیکدی که نشان دهنده علامت سِنت است:
>>> unicode_test('\u00a2')
value="¢",
name="CENT
SIGN", value2="¢"
حرف
یونیکدی که نشان دهنده علامت ارز یورو است:
>>> unicode_test('\u20ac')
value="€",
name="EURO
SIGN", value2="€"
تنها
مشکل بالقوهای که ممکن است در این رابطه با آن مواجه
شوید محدودیت فانتهایی است که برای نمایش متن از آن استفاده
میکنید. همه فانتها، کلیه حروف یونیکد را در خود ندارند، و ممکن است برای حروفی که تصویر
آن را ندارند از تصاویر جایگزین استفاده کنند. برای نمونه، حرفی که نماد آدم برفی
است، و فقط در فانتهای dingbat دیده میشود بصورت زیر است:
>>> unicode_test('\u2603')
value="☃",
name="SNOWMAN",
value2="☃"
فرض
کنیم بخواهیم بخواهید لغت café را در یک رشته پایتون
ذخیره کنید. یک راه این است که از این لغت کپی بگیرید و امیدوار باشید که درست
ذخیره شود:
>>> place
= 'café'
>>>
place
'café'
کد
فوق به این دلیل درست عمل میکند که من این لغت را از منبعی کپی کردهام که از کد utf-8
استفاده میکند (و شما بزودی با آن آشنا خواهید شد).
ولی ما در
پایتون چگونه میتوانیم حرفی مانند é را مشخص کنیم؟ اگر
شما به مرجع حروف یونیکد رجوع کنید خواهید دید که نام رسمی این حرف بصورت "E WITH ACUTE, LATIN SMALL LETTER" است، و مقدار آن 00E9. حالا بیایید
توابع name() و lookup()را بر روی این
حرف اعمال کنیم. ابتدا کد عددی را میدهیم تا نام حرف
را بگیریم:
>>>
unicodedata.name('\u00e9')
'LATIN SMALL LETTER E WITH ACUTE'
سپس
نام حرف را میدهیم تا کد عددی آن را بگیریم:
>>> unicodedata.lookup('E WITH ACUTE, LATIN SMALL LETTER')
Traceback
(most recent call last):
File
"<stdin>", line 1, in
<module>
KeyError:
"undefined character name 'E WITH ACUTE, LATIN SMALL LETTER'"
دلیل خطای پدید آمده این است که نامهایی که در مرجع
اینترنتی نمایش داده شدهاند بصورتی قالب بندی شده که برای نمایش مناسب باشند. برای تبدیل این اسامی به نامهای واقعی یونیکد (که پایتون از آنها استفاده میکند)، باید کاماها را حذف کرده و آن بخش از نام
را که بدنبال کاما آمده در ابتدا ذکر کنید. به این ترتیب نام "E WITH ACUTE, LATIN SMALL LETTER" به "LATIN SMALL LETTER E WITH ACUTE" تبدیل خواهد شد:
>>> unicodedata.lookup('LATIN
SMALL LETTER E WITH ACUTE')
'é'
حالا میتوانید حرف é
در لغت café
را، یا بصورت کد آن، و یا به صورت نام آن، مشخص کنید:
>>> place = 'caf\u00e9'
>>> place
'café'
>>>
place = 'caf\N{LATIN
SMALL LETTER E WITH ACUTE}'
>>>
place
'café'
در
مثال قبلی، ما حرف é را مستقیماً در رشته
وارد کردیم، ولی میتوانیم رشته خود را با الحاق حروف مورد نظر نیز بسازیم:
>>> u_umlaut = '\N{LATIN SMALL LETTER U WITH DIAERESIS}'
>>> u_umlaut
'ü'
>>>
drink = 'Gew'
+ u_umlaut + 'rztraminer'
>>>
print('Now
I can finally have my', drink, 'in a', place)
تابع
len تعداد حروف یونی کد در یک
رشته را بازمیگرداند، نه تعداد بایتهای تشکیل دهنده آن را:
>>>
len('$')
1
>>>
len('\U0001f47b')
1
کُدگذاری و کُدگُشایی حروف با استاندارد UTF-8
هنگامی که
مشغول پردازشهای عادی بر روی رشتهها هستید،
نیازی نیست نگران این باشید که پایتون چگونه حروف مختلف یونیکد را
ذخیره میکند.
ولی
هنگامی که مشغول تبادل اطلاعات با جهان خارج (از پایتون) هستید، باید به چند مورد
توجه داشته باشید:
· اتخاذ روشی برای کدگذاری (encode)
حروف و تبدیل آنها
به بایتها.
· اتخاذ روشی برای کدگشایی (decode)
بایتها و تبدیل آنها به رشتههای حرفی.
اگر
تعداد حروف یونیکد از 64000 کمتر بود، ما برای ذخیره شناسه هر یک از
آنها میتوانستیم از دو بایت استفاده کنیم. ولی متاسفانه تعداد آنها خیلی
بیشتر است. ما میتوانیم شناسه هر حرف را در سه یا چهار بایت
ذخیره کنیم، ولی اینکار باعث میشود تا فضای لازم برای ذخیره متنهای رشتهای 4 برابرشود.
کن
تامپسون (Ken Thompson) و راب پایک (Rob
Pike)، که شهرت آنها بخاطر خلق سیستم عامل یونیکس است، روزی
که در نیوجرسی با هم شام میخوردند، سیستم کدگذاری پویای UTF-8 را طراحی کردند. حُسن این
سیستم در این است که برای حروف مختلف، بسته به کاربرد آنها، از 1 تا 4 بایت استفاده میشود:
·
یک بایت برای حروف ASCII
·
دو بایت برای اکثر حروف زبانهای لاتین-پایه (البته
بجز حروف سریلیک).
·
و سه بایت هم برای بقیه حروف پلان چندزبانه اصلی.
·
چهار بایت برای بقیه زبانها، از جمله زبانهای چینی، ژاپنی، کرهای و غیره.
utf-8
استاندارد کدگذاری اصلی
متن در پایتون، و همچنین HTML،
است. این استاندارد کامل و سریع است و بخوبی جواب میدهد. اگر شما در کد نویسی خود از کدگذاری utf-8 استفاده کنید، در مقایسه با
بقیه استانداردهای کدگذاری،
کارتان بسیار راحتتر خواهد بود.
اگر با استفاده از کپی کردن و چسباندن از
منابع دیگر (مثلاً یک صفحه وِب) یک رشته پایتون را ایجاد میکنید، مطمئن شوید که آن
صفحه بصورت UTF-8 کدگذاری شده.
بسیار دیده شده که متونی که با استاندارد Latin-1 و یا Windows
1252کدگذاری شدهاند، و در پایتون کپی میشوند، برنامه نویس را با
اعتراضی مبنی بر ” غیرمجاز بودن یک دنباله
بایتی“ مواجه میکنند.
...........................................
برای ادامه مطالعه این فصل نسخه
کامل PDF کتاب را تهیه کنید.
فصل 8
ذخیره
سازی دادهها
برنامههایی که در حال اجرا بر روی کامپیوتر هستند، دادههایی را مورد دسترسی قرار میدهد که در RAM ذخیره شدهاند. سرعت حافظه RAM
بسیار زیاد است، ولی گِران نیز هست و برای پایداری دادههایی که در آن
ذخیره میشود نیاز است همیشه در آن برق جریان داشته
باشد، این یعنی اگر به هر دلیلی جریان برق قطع شود، دادههای موجود در RAM
نیز از بین خواهند رفت. دیسک درایوها نسبت به RAM آهستهترند، ولی ظرفیت بیشتری دارند، قیمت آنها کمتر است، و حتی اگر برق قطع شود،
دادههایی که قبلاً روی آنها ذخیره شده از بین نمیروند. بنابراین در سیستمهای کامپیوتری تلاش بسیاری صورت میگیرد تا بین ذخیرهسازی دادهها بر روی RAM
و دیسک تعادلی برقرار شود. ما بعنوان یک برنامهنویس، به پایداری دادهها (persistence)
نیاز داریم: یعنی ذخیرهسازی و بازیافت دادهها با استفاده از رسانههای غیرفرار مانند دیسکها.
این
فصل تماماً به بررسی روشهای مختلف ذخیرهسازی دادهها اختصاص یافته، روشهایی که هر یک برای منظور خاصی بهینه شدهاند: فایلهای ساده، فایلهای ساختیافته، و پایگاههای داده. عملیات فایلی، به غیر از ورودی و خروجی، در فصل 10 بررسی خواهند شد.
این فصل همچنین اولین فصلی خواهد بود که
مثالهایی از کاربرد ماجولهای غیر استاندارد پایتون در آن میآید؛ یعنی برنامههای
پایتون که در آنها از ماجولهایی به غیر از کتابخانه استاندارد استفاده میشود. این
ماجولها با استفاده از دستور pip نصب میشوند. در ضمیمه D جزئیات بیشتری درمورد نصب
ماجولهای خارجی آمده است.
عملیات
ورودی/خروجی بر روی فایلها
استفاده
از فایلهای سادهِ قدیمی، که برخی اوقات به آنها فایل
صاف (flat file) نیز میگویند، سادهترین روش برای ذخیرهسازی دادهها است. این فایلها فقط از دنبالهای از بایتها تشکیل شدهاند که تحت یک نام ذخیره میشوند. شما دادهها را از یک فایل خوانده و آنها را به حافظه
میفرستید، به همین ترتیب دادهها را از حافظه گرفته و آن را در فایل مینویسید. پایتون اینگونه عملیات را برای شما ساده کرده. عملیات فایلی پایتون
شبیه یونیکس است، که باعث میشود این عملیات برای بسیاری از برنامهنویسان آشنا بنظر برسد. پیش از خواندن یا نوشتن یک فایل، باید آن را باز کنید:
fileobj
= open(
filename, mode )
توضیح کُد بالا را در زیر مشاهده میکنید:
·
fileobj
شیئی است که تابع open() بازمیگرداند.
·
filename
نام رشتهای فایل است.
·
mode رشتهای است که بر نوع فایل، و آنچه شما میخواهید با آن انجام دهید، دلالت دارد.
اولین
حرف mode
بر عمل مورد نظر دلالت دارد، و میتواند شامل موارد زیر باشد.
· r برای خواندن است.
·
w برای نوشتن است. اگر
فایل از قبل موجود نباشد، ایجاد میشود، و اگر هم فایلی با این نام از قبل
موجود باشد، با فایل جدید جایگزین میشود.
·
x برای نوشتن است، ولی
فقط درصورتی که چنین فایلی از قبل موجود نباشد.
·
a بر append
دلالت دارد (اضافه به آخر)، البته درصورتی که فایل از قبل موجود باشد.
دومین
حرف mode
بر نوع فایل دلالت دارد و میتواند شامل موارد زیر باشد:
·
t مخفف text است، که
یعنی فایل از نوع متنی است.
·
b مخفف binary است، که
یعنی فایل از نوع باینری است.
پس
از باز کردن فایل میتوانید با فراخوانی توابع مربوطه، که آنها را در مثالهای بعدی
نشان خواهم داد، دادهها را از فایل خوانده، یا در آن بنویسید.
نهایتاً،
پس از اتمام کارتان باید فایل را ببندید.
بیایید
تا یک رشته پایتون ایجاد کرده و آن را در یک فایل بنویسیم:
ابتدا
رشتهای بنام poem ایجاد میکنیم، که حاوی شعر زیر است:
>>>
poem = '''There
was a young lady named Bright,
... Whose speed was far faster than light;
... She started one day
... In a relative way,
... And returned on the previous night.'''
>>> len(poem)
150
در
کد زیر تمام این رشته در فایلی بنام 'relativity' نوشته میشود:
>>> fout = open('relativity',
'wt')
>>> fout.write(poem)
150
>>>
fout.close()
تابع
write() تعداد حروفی که در فایل نوشته
شدهاند را بازمیگرداند. این تابع
برخلاف کاری که print() انجام میدهد، هیچ خط جدیدی را اضافه نمیکند. همچنین برای نوشتن در یک فایل متنی میتوانید از print() استفاده کنید:
>>> fout = open('relativity', 'wt')
>>> print(poem, file=fout)
>>>
fout.close()
اینجا
این سئوال مطرح میشود که آیا باید ازwrite()
استفاده کرد یا از print() ؟ بطور پیشفرض print()پس از هر یک آرگومانهای خود یک فاصله، و در انتها نیز یک خط جدید اضافه میکند. در مثال قبل، این تابع به فایل relativity
یک خط جدید اضافه میکند. به منظور اینکه تابع print() مشابه write()
کار کند،
آرگومانهای زیر را به آن اضافه کرده و مقدار آنها
را یک رشته خالی قرار دهید:
·
sep که مشخص کننده جداکننده
آرگومانها است، و مقدار پیشفرض آن حرف فاصله ' ' است.
·
end که مشخص کننده پایان است و
مقدار پیشفرض آن حرف خط جدید '\n'
است.
تابع
print() از مقادیر پیشفرض استفاده میکند، ولی ما برای جلوگیری از کلیه عملکردهای
پیشفرض، رشته خالی به آن میدهیم:
>>>
fout = open('relativity', 'wt')
>>> print(poem, file=fout, sep='', end='')
>>>
fout.close()
همچنین
اگر یک رشته بزرگ داشته باشید، میتوانید هر بار تکهای از آن را بنویسید تا تمام شود:
>>> fout = open('relativity', 'wt')
>>> size
= len(poem)
>>>
offset = 0
>>> chunk =
100
>>>
while True:
...
if offset > size:
...
break
... fout.write(poem[offset:offset+chunk])
... offset += chunk
...
100
50
>>> fout.close()
در
تلاش نخست، 100 حرف در فایل نوشته میشود و در تلاش
بعدی 50 حرف دیگر نیز نوشته خواهند شد.
در صورتی
که فایل relativity از اهمیت خاصی
برخوردار باشد، آنگاه با مشخص کردن حالت x، میتوانید از آن در برابر رونویسی محافظت کنید:
>>>
fout = open('relativity', 'xt')
Traceback
(most recent call last):
File
"<stdin>", line 1, in
<module>
FileExistsError:
[Errno 17] File exists: 'relativity'
همچنین
میتوانید از یک رسیدگی کننده به اعتراض استفاده کنید:
>>> try:
... fout = open('relativity', 'xt')]
...
fout.write('stomp stomp stomp')
...
except FileExistsError:
...
print('relativity
already exists!. That was a close one.')
...
relativity
already exists!.
That was a close one.
خواندن یک فایل
متنی با توابع read()، readline()، و readlines()
همانطور
که در مثال بعدی دیده میشود، شما میتوانید با فراخوانیread() ،
بدون ذکر هیچ آرگومانی، تمامی
یک فایل را در یک مرحله بخوانید. هنگامی که این عمل را درمورد فایلهای بزرگ انجام میدهید باید مراقب باشید؛ زیرا، مثلاً با این
روش خواندن یک فایل یک گیگا بایتی، یک گیگا بایت از حافظه شما را نیز اشغال خواهد کرد:
>>> fin
= open('relativity',
'rt' )
>>> poem = fin.read()
>>> fin.close()
>>>
len(poem)
150
شما
میتوانید حداکثر حروفی که تابع read()در هر فراخوانی باز
میگرداند را تعیین کنید. بیایید در هربار 100 حرف را
خوانده، و آنها را به رشته poem اضافه کنیم تا در
نهایت با افزودن آنها شعر اصلی ساخته شود:
>>>
poem = ''
>>> fin = open('relativity', 'rt' )
>>> chunk =
100
>>>
while True:
...
fragment = fin.read(chunk)
...
if not fragment:
...
break
... poem += fragment
...
>>> fin.close()
>>>
len(poem)
150
پس
از اینکه از ابتدا تا انتهای فایل را خواندید، فراخوانیهای بعدی تابع read() تنها یک رشته خالی ('') را برای شما باز میگرداند، و باعث میشود عبارت شرطی if not
fragment بعنوان False
برآورد شود، و همین موجب شکسته شدن حلقه while True و خروج
از آن میشود.
همچنین میتوانید یک فایل را با استفاده از فراخوانی readline() خط به خط بخوانید. در
مثال بعدی ما فایل را خط به خط خوانده، و این خطوط را به رشته poem اضافه میکنیم تا شعر اصلی حاصل شود:
>>> poem
= ''
>>> fin = open('relativity', 'rt' )
>>>
while True:
...
line = fin.readline()
...
if not line:
...
break
... poem +=
line
...
>>> fin.close()
>>>
len(poem)
150
برای
یک فایل متنی، حتی اگر یک خط خالی هم داشته باشد، طول آن یک است (زیرا فقط یک حرف
دارد که آنهم حرف خط جدید است)،
و این باعث میشود عبارت به True ارزیابی
شود. هنگامی که کلیه خطوط خوانده شدند، مانند readl()،
readline() نیز یک رشته خالی را بازمیگردانند، که دراینجا نیز به False
برآورد میشود.
سادهترین راه برای خواندن یک فایلِ متنی استفاده از یک تکرار کننده (iterator)
است. کُد زیر همان کاری را انجام میدهد که برنامههای قبلی انجام میدادند، ولی با کُد کمتر:
>>> poem
= ''
>>> fin = open('relativity', 'rt' )
>>>
for line
in fin:
...
poem += line
...
>>>
fin.close()
>>>
len(poem)
150
...........................................
برای ادامه مطالعه این فصل نسخه کامل PDF کتاب را تهیه کنید.
فصل 9
برنامه
نویسی وِب در پایتون
جایی در
میان مرز فرانسه و سوییس، مرکز تحقیقات هستهای CERN قرار دارد که مثال
خوبی برای وقوع فیلمهای اکشن است. خوشبختانه هدف این مرکز نه
استیلا بر جهان، بلکه درک چگونگی کارکرد آن است. به همین دلیل است که مرکز CERN انبوه زیادی داده تولید میکند، و از این طریق همیشه فیزیکدانان و دانشمندان علوم کامپیوتر را به چالش میطلبد.
ابتدا
در سال 1989 فیزیکدان انگلیسی تیم برنرز- لی (Tim Berners-Lee)
راهکاری را پیشنهاد داد که کمک میکرد اطلاعات در میان جامعه محققین CERN رد و بدل شوند. او نام ” تار
جهان گستر“ (World
Wide Web) را بر روی این ایده گذاشت، چیزی که حالا با نام مخفف
آن، یعنی www، شناخته میشود. اساس این تکنولوژی بر سه اصل ساده قرار دارد:
·
HTTP (Hypertext
Transfer Protocol) یا قرارداد
تبادل ابرمتن، که عبارت
است از ویژگیهایی که سرویسگیرندهها و سرویسدهندههای وِب باید دارا باشند تا بتوانند درخواستها و پاسخها را با یکدیگر رد و بدل کنند.
·
HTML (Hypertext
Markup Language)یا زبان نشانهگذاری ابرمتن، که عبارت است از فرمت بندی نتایج نشان داده شده.
·
URL (Uniform
Resource Locator) یا تعیین
کنند منبع یکنواخت، که
روشی است برای نشان دادن یک سرویسدهنده و منابعی که بر روی آن قرار دارند.
در
سادهترین شکل آن، ارتباط این سه را میتوان چنین بیان کرد: یک مشتری وِب (مثلاً یک مرورگر) بر اساس HTTP به یک
سرویسدهنده وِب
متصل شده و یک URL را درخواست میکند، و در نهایت یک HTML را
دریافت میکند.
برنرز-
لی اولین کسی بود که یک وب سرور،
و نیز یک مرورگر وب (browser)،
را نوشت. او این کار را
بر روی یک کامپیوتر NeXT انجام داد (همان کامپیوتر معروفی که استیو جابز بعد از جدایی موقت خود از
شرکت اپل اختراع کرد). در واقع آگاهی نسبت به وِب هنگامی افزایش یافت که در سال
1993 گروهی از دانشجویان دانشگاه ایلینوی مرورگر موزاییک (Mosaic)
و سرویس دهنده وبِ NCSA را بیرون دادند. در آن زمان، وقتی من این برنامهها را دانلود کردم و با آنها چند سایت ساختم، هیچ وقت تصور نمیکردم که ممکن است تکنولوژی اینترنت و وِب تا این حد گسترش یابد و به جرئی از زندگی روزمره مردم بدل
شود. در آن زمان اینترنت هنوز بطور رسمی غیرتجاری محسوب میشد؛ تعداد کل سرویس دهندگان شناخته شده وب در سراسر جهان چیزی حدود 500 عدد
بود! ولی این تعداد تا پایان سال 1994 به 000,10 افزایش یافت. از آن
زمان دریچه اینترنت به کارهای تجاری گشوده شد، و سازندگان مرورگرِ موزاییک شرکت Netscape را تاسیس کردند تا در آنجا به توسعه نرمافزارهای تجاری وِب بپردازند. در آن زمان که جهان بطور دیوانهواری به سمت اینترنت حرکت میکرد، Netscape نیز معروف شد. از آن موقع به بعد
نیز، هرگز توسعه انفجار آمیز وِب متوقف نشد.
تقریباً
از تمام زبانهای کامپیوتری برای نوشتن سرویسگیرندهها و سرویسدهندههای وِب استفاده شده. در این میان زبانهایی نظیر Perl، PHP، و Rubyمحبوبیت زیادی داشتهاند. در این فصل من نشان خواهم داد که چرا مخصوصاً پایتون زبان خوبی برای جنبههای مختلف برنامه نویسی وب بحساب
میآید، از جمله:
·
برای سرویسگیرندهها تا به سایتهای دور دسترسی پیدا کنند.
·
برای سرویس دهندهها که دادههایی را برای وبسایتها فراهم میآورند.
·
برای APIها،
و همینطور سرویسهای مربوط به وب، که دادهها را به شکلی غیر از آنچه بر روی صفحات وِب نمایش داده میشود با یکدیگر رد و بدل میکنند.
و
همینطور که جلو میرویم، در تمرینهای پایان این فصل یک سرویس دهنده وِب خواهیم ساخت.
سرویسگیرندههای وِب
پایینترین سطح اتصالات شبکه اینترنت،
TCP/IP
نامیده میشود. در فصل 11 جزئیات بیشتری در مورد TCP/IP خواهد آمد. با
استفاده از این قرارداد، بایتها میان
کامپیوترها انتقال داده میشوند، ولی در اینجا مهم نیست که معنی این
بایتها چیست و چه کاری انجام میدهند. این وظیفه لایه
بالاتر (یعنی لایه protocols) است که وظیفه این بایتها را تعریف کند. پروتکل استانداردی برای تبادل دادههای وِب HTTP است. وِب یک سیستم سرویسدهنده-سرویسگیرنده است. سرویسگیرنده (یا مشتری) چیزی را از یک سرویسدهنده (یا سرور) درخواست (request)
میکند، به اینصورت که:
1- ابتدا یک اتصال TCP/IP را باز
میکند.
2- URL و دیگر
اطلاعات مورد نظر خود را با استفاده از قرار داد HTTP به سرور
میفرستد.
3- و در مقابل از سرور یک پاسخ (response)
میگیرد.
فرمت
پاسخ نیز
توسط HTTP تعریف
شده است. این شامل وضعیت (status)
درخواست، و فرمت دادههای پاسخ است.
معروفترین
نمونه برای سرویسگیرنده وب، یک مرورگر وِب است. مرورگر میتواند درخواستهای HTTP خود را به طرق مختلفی بفرستد. شما میتوانید اینکار را با وارد کردن دستی یک URL در
مرورگر انجام دهید، یا اگر درحال دیدن یک صفحه وب هستید، میتوانید روی یک لینک کلیک
کنید. در بسیاری از اوقات، از داده
بازگردانده شده برای نمایش اطلاعات روی صفحه استفاده میشود. این دادهها شامل مستندات HTML، فایلهای تصویری، فایلهای JavaScript و CSS
هستند. ولی این دادهها میتواند از هر گونهای باشد، نه فقط آنهایی که برای نمایش از
آنها استفاده میشود.
یک
جنبه مهم HTTP بیوضعیتی (stateless)
آن است. هر اتصال HTTP
که میسازید مستقل از بقیه است. این باعث میشود تا عملیات اساسی وِب سادهتر شوند، ولی درمقابل برای برخی عملیات دیگر
پیچیدگیهایی را به همراه میآورد. از میان آنها، موارد زیر چالشبرانگیز هستند:
·
کَش کردن دادهها (Caching): دادههای دوری (Remote) که تغییر نمیکنند باید توسط سرویسگیرنده ذخیره شوند تا بجای اینکه هر بار از سرویس
گیرنده دانلود
شوند، از آنها بصورت محلی استفاده شود.
·
جلسهها (Sessions): در طول گشت و گذار شما به صفحات مختلف یک
سایت خرید، این سایت باید محتوای سبد خرید شما را بخاطر داشته باشد.
·
اعتبار سنجی (Authentication):
سایتهایی که از شما شناسه کاربری و کلمهعبور میخواهند، در طول زمانی که در سایت فعالیت میکنید، سرور باید شناسه
و کلمهعبور شما را بخاطر داشته باشند.
یکی
از راه حلهایی که برای مشکل بیوضعیتی وجود
دارد استفاده از کوکیها (cookie)
است، که از این طریق سرویسگیرنده اطلاعات خاصی را به سرویسدهنده میفرستد تا شناسه منحصر بفرد او را مشخص کند.
HTTP قراردادی متن- پایه است، به همین دلیل شما برای آزمایشاتی
که انجام میدهید میتوانید دستورات آن را در کامپیوتر خود تایپ کنید. برنامه قدیمی telnet به شما این امکان را میدهد که به هر سروری با هر پورتی متصل شده و دستوراتی را تایپ کنید.
بیایید
تا کار خود
را با سایت گوگل آغاز
کنیم، سایتی که بسیاری از برنامهنویسان آزمایشات خود را بر روی آن انجام میدهند. در اینجا ما برخی از اطلاعات اساسی صفحه اصلی (home page)
این سایت را میگیریم:
$ telnet
www.google.com
80
اگر سرویسدهندهای باشد که در پورت 80 سایتی بنام google.com گوش بزنگ ایستاده (که شرط میبندم که هست!)، telnet اطلاعات اطمینان بخشی
را چاپ میکند و نهایتاً یک خط خالی را نمایش میدهد که حاکی از این است که میتوانید دستورات دیگری را وارد کنید:
Trying 74.125.225.177...
Connected
to www.google.com.
Escape
character is '^]'.
حالا
یک دستور واقعی HTTPرا وارد کنید تا telnet آن را برای سرویس دهنده گوگل بفرستد. متداولترین دستور HTTP (یعنی همان دستوری که هنگام تایپ یک URL توسط شما
در نوار مرورگر، فرستاده میشود) دستور GET است. این دستور محتوای منبع مشخص شده
(مثل یک فایل HTML)
را گرفته و آن را به سرویسگیرنده بازمیگرداند. برای اولین آزمایش خود، ما از دستور HEAD استفاده میکنیم، که کارش گرفتن برخی اطلاعات اساسی
درمورد منبع مورد نظر است:
HEAD
/ HTTP/1.1
دستور ”HEAD /
“، فرمان HTTP مربوطه را میفرستد تا
اطلاعاتی را در مورد صفحه (/) دریافت کند. باید یک
خط خالی اضافی را نیز بفرستید تا به کامپیوتر سرویس دهنده بفهمانید که کار شما تمام شده و منتظر پاسخ هستید. پاسخی که دریافت میکنید چیزی شبیه به زیر است (البته برای اینکه برخی از خطوط بلند از صفحه خارج
نشوند ما آنها را به خط بعدی انتقال دادهایم):
HTTP/1.1
200 OK
Date: Sat,
26 Oct 2013 17:05:17 GMT
Expires:
-1
Cache-Control: private, max-age=0
Content-Type: text/html;
charset=ISO-8859-1
Set-Cookie: PREF=ID=962a70e9eb3db9d9:FF=0:TM=1382807117:LM=1382807117:S=y...
expires=Mon, 26-Oct-2015 17:05:17 GMT;
path=/;
domain=.google.com
Set-Cookie: NID=67=hTvtVC7dZJmZzGktimbwVbNZxPQnaDijCz716B1L56GM9qvsqqeIGb...
expires=Sun, 27-Apr-2014 17:05:17 GMT
path=/;
domain=.google.com;
HttpOnly
P3P: CP="This is not a P3P policy! See
http://www.google.com/support/accounts...
Server:
gws
X-XSS-Protection:
1; mode=block
X-Frame-Options:
SAMEORIGIN
Alternate-Protocol: 80:quic
Transfer-Encoding: chunked
خطوط
فوق، سرآمدهای (headers) پاسخ HTTP هستند.
برخی از آنها مثل Date و Content-Typeخیلی مورد
نیازند، و برخی دیگر نیز مثل Set-Cookie برای ردیابی فعالیتهای شما در طول ملاقاتهای متعددی که انجام میدهید مورد استفاده قرار میگیرند (ما بعداً در همین فصل به چگونگی مدیریت
وضعیت (state
management) خواهیم پرداخت). هنگامی که یک درخواست HTTP HEAD انجام میدهید، شما تنها سرآمدها را
دریافت خواهید کرد. ولی اگر از دستورهای GET
یا POSTاستفاده کنید، دادههای مربوط به صفحه مورد نظر را نیز دریافت میکنید (مخلوطی از HTML, CSS,
JavaScript و هر آنچه گوگل بعنوان صفحه اصلی خود در نظر گرفته).
بدلیل
اینکه نمیخواهم در telnet باقی بمانید، پس با وارد کردن
q از آن خارج شوید.
کتابخانههای
استاندارد وِب در پایتون
در پایتون
2، ماجولهای سرویسدهنده و
سرویسگیرنده وِب تا اندازهای پراکنده هستند. یکی از اهداف پایتون 3 این بود که این
ماجولها را در دو پکیج بستهبندی (bundle)
کند (همانطور که در فصل 5 اشاره شد،
پکیج فقط یک دایرکتوری است که در آن فایلهایی قرار دارند،
که هریک حاوی یک ماجول
هستند):
·
پکیج http
کلیه جزئیات سرویسدهنده- سرویسگیرنده HTTP را مدیریت میکند:
o client به موارد مربوط به سرویسگیرنده رسیدگی
میکند.
o server به شما کمک میکند تا سرویسدهندههای وب را
به زبان پایتون بنویسید.
o cookies
و cookiejarکوکیها را مدیریت میکنند
(همانهایی که در هنگام ملاقات به صفحات سایت ذخیره میشوند).
·
پکیج urllib در بالای http اجراء میشود:
o request:
به درخواست سرویسگیرنده رسیدگی
میکند.
o :response به پاسخ سرویسدهنده رسیدگی
میکند.
o parse:
URL را به
قسمتهای مختلف تقسیم میکند.
بیایید
تا با استفاده از کتابخانه استاندارد، اطلاعاتی را از یک وبسایت بگیریم. URL که در مثال زیر بکار رفته، هر بار بصورت تصادفی یک
نقلقول را باز میگرداند، چیزی شبیه کاغذهایی که در شیرینیهای شانسی (fortune cookie)
قرار دارد.
>>>
import urllib.request as ur
>>> url = 'http://www.iheartquotes.com/api/v1/random'
>>>
conn = ur.urlopen(url)
>>>
print(conn)
<http.client.HTTPResponse
object at 0x1006fad50>
اگر
به مستندات مربوطه رجوع کنید، میبینید که conn شیئی از گونه HTTPResponse است که متدهای متعددی
دارد، و متد read() یکی از این متدها است که دادهها را از صفحه وب خوانده
و آن را به ما بازمیگرداند:
>>> data = conn.read()
>>> print(data)
b'You will be surprised by a loud
noise.\r\n\n[codehappy]
http://iheartquotes.com/fortune/show/20447\n'
کاری
که این برنامه کوچک پایتون انجام میدهد این است که: 1- یک اتصال TCP/IP را به
سمت سرویسدهنده باز (open)
میکند، 2- یک درخواست HTTP ایجاد میکند، و 3- یک پاسخ HTTP
دریافت میکند. پاسخ دریافت شده تنها حاوی دادههای صفحهِ مربوطه نیست. یکی از مهمترین بخشهای پاسخ، کُد وضعیت HTTP
است:
>>> print(conn.status)
200
کد
200 یعنی اینکه همه چیز خوب پیش رفته. کدهای
وضعیتِ مختلفی برای HTTP وجود دارند، که به پنج گروه مختلف تقسیم میشوند و رقم صدگان آنها مشخص کننده گروه آنها است:
1xx (کدهای اطلاعاتی): سرویسدهنده درخواست را دریافت کرده، ولی برخی اطلاعات اضافی را
برای سرویسگیرنده دارد.
2xx (کدهای موفقیت): همه
چیز درست کار کرده؛
کدهایی به غیر از 200 حاوی اطلاعات
اضافی هستند.
3xx (کدهای تغییرمسیر redirection):
منبع جابجا شده، بنابراین پاسخ بازگردانده
شده، یک URL جدید را
به سرویسگیرنده بازمیگرداند.
4xx (کدهای خطای سرویسگیرنده): برخی خطاها از طرف سرویسگیرنده پیش آمده.
مثل خطای معروف 404 (not
found).
5xx (کدهای خطای
سرویسدهنده): 500 یک کد خطای عمومی
است. برخی اوقات هم ممکن است شما کد 502 (bad gateway) را ببیند که هنگامی
پیش میآید که ارتباط بین یک سرویسدهنده وِب و یک برنامه سرویسدهنده قطع شود.
سرویسدهندههای وب میتوانند دادهها را به هر فرمتی که میخواهند به شما بفرستند. این فرمت معمولاً HTML است (در
برخی موارد هم، CSS
و JavaScript)، ولی در مثال ما،
این فرمت فقط متن خالص است. فرمتِ دادهِ بازگردانده شده در بخش Content-Type سرآمدِ پاسخ قرار دارد، که ما در مثال قبلی مربوط به google.com
آن را دیدیم:
>>>
print(conn.getheader('Content-Type'))
text/plain
text/plain
یکی از گونههای MIME است، که مشخص کننده
متنهای ساده قدیمی است. گونهِ MIME دادههای HTML (همان که
سایت google.com برای ما فرستاد) text/html
است. من گونههای MIME دیگری را نیز در همین فصل به شما نشان خواهم داد.
فقط از
روی کنجکاوی میخواهیم بدانیم چه سرآمدهای HTTP دیگری
فرستاده شده:
>>>
for key,
value in conn.getheaders():
... print(key, value)
...
Server
nginx
Date
Sat, 24 Aug 2013
22:48:39 GMT
Content-Type text/plain
Transfer-Encoding chunked
Connection
close
Etag "8477e32e6d053fcfdd6750f0c9c306d6"
X-Ua-Compatible
IE=Edge,chrome=1
X-Runtime 0.076496
Cache-Control max-age=0, private, must-revalidate
حتماً
مثال telnet
که چند صفحه قبل مطرح کردم را بخاطر
دارید؟ در آنجا همه این سرآمدها نشان
داده شده بود، ولی حالا کتابخانه پایتون کلیه سرآمدهای HTTP را تجزیه کرده و آنها را بصورت یک دیکشنری برای ما
فرآهم آورده. اسم سرآمدهایی مثل Date یا Serverگویا است، ولی
برخی نیز هستند که نام آنها کمتر گویا است.
...........................................
برای ادامه مطالعه این فصل نسخه
کامل PDF کتاب را تهیه کنید.
فصل 10
سیستم
کاری که یک
کامپیوتر میتواند انجام دهد و بیشتر انسانها نمیتوانند، آن است که میتوان آن را در جعبهای بسته بندی کرد و در گوشهای از یک انبار قرار داد.
جَک هَندی
در میان
کارهایی که روزانه با یک کامپیوتر انجام میشود، میتوان به کارهایی نظیر گرفتن محتوای یک دایرکتوری، و ایجاد یا حذف فایلها اشاره کرد.
گرچه این کارها چندان هیجان انگیز نیستند، ولی مانند امور خانهداری، انجام آنها لازم است. شما میتوانید همه
اینکارها، و نیز موارد بیشتری را از داخل برنامههای پایتون خود انجام دهید. آیا این باری را از دوش شما برخواهد داشت یا چیزی
به آن اضافه میکند؟ این موضوعی است که در ادامه خواهیم
دید.
پایتون
از طریق ماجولی بنام os (“Operating
System” یا سیستم عامل)، بسیاری از این کارها را برای شما انجام میدهد. ما در تمام مثالهای این بخش این ماجول را import خواهیم کرد.
فایلها
مانند
بسیاری از زبانهای برنامهنویسی، عملیاتِ فایلی پایتون نیز بر اساس
سیستم عامل یونیکس بنا شده است. برخی از این توابع مانندchown() و chmod()، نام یکسانی با همتاهای یونیکسی
خود دارند، ولی در پایتون تعدادی تابع جدید نیز به آنها اضافه شده است.
ما در فصل
8 تابع open()
را معرفی کردیم و توضیح دادیم
که چگونه میتوان برای بازکردن یک فایل، یا ایجاد یک
فایل جدید، از آن استفاده کرد. بیایید تا فایلی بنام oops.txt
را ایجاد کنیم.
>>>
fout = open('oops.txt', 'wt')
>>> print('Oops, I created a file.',
file=fout)
>>>
fout.close()
پس
از انجام اینکار، بیایید چند آزمایش را بر روی این فایل انجام دهیم:
برای
اینکه ببینید یک فایل یا یک دایرکتوری واقعاً وجود دارد یا نه، میتوانید با دادن مسیر مطلق یا
نسبیِ فایل به تابع exists()،
از موجود بودن آن اطمینان حاصل کنید:
>>> import
os
>>> os.path.exists('oops.txt')
True
>>>
os.path.exists('./oops.txt')
True
>>>
os.path.exists('waffles')
False
>>> os.path.exists('.')
True
>>> os.path.exists('..')
True
بررسی گونه با استفاده از isfile()،isdir()
این توابع
بررسی میکنند که آیا نام داده شده به آنها، به یک
فایل، به یک دایرکتوری، یا به یک پیوند سمبولیک (symbolic link) اشاره میکند (به مثالهایی که بعد از این میآید نگاه کنید).
برای
اینکه ببینیم آیا فایل ما یک فایل ساده است یا نه، از تابع isfile استفاده میکنیم:
>>> name
= 'oops.txt'
>>> os.path.isfile(name)
True
در
مثال زیر ما دایرکتوری بودن یک نام را بررسی میکنیم:
>>> os.path.isdir(name)
False
در
نام گذاری مسیرها، یک نقطه تنها (.)، نشان دهنده
دایرکتوری جاری، و دو نقطه (..) نشان دهنده
دایرکتوری والد است. این دو دایرکتوری همیشه وجود دارند، بنابراین عباراتی مانند
زیر، همیشه True را بازمیگردانند:
>>> os.path.isdir('.')
True
ماجول os حاوی توابع زیادی است که با مسیرها (pathname)
سروکار دارد. یک از آنها isabs() است که مشخص میکند آیا آرگومان داده شده به آن یک مسیر مطلق است یا نه. لازم نیست نام داده شده به این
تابع حتماً واقعی باشد:
>>> os.path.isabs(name)
False
>>>
os.path.isabs('/big/fake/name')
True
>>>
os.path.isabs('big/fake/name/without/a/leading/slash')
False
کپی فایلها با
استفاده از copy()
تابعcopy() از ماجول دیگری بنام shutil میآید. در مثال زیر فایل oops.txt در فایل ohno.txt کپی میشود:
>>> import shutil
>>> shutil.copy('oops.txt', 'ohno.txt')
تابع
shutil.move() فایل را کپی کرده و
سپس فایل اصلی را حذف میکند.
این تابع
نام یک فایل یا دایرکتوری را تغییر میدهد. در مثال زیر
نام فایل ohno.txt به ohwell.txt
تغییر داده میشود:
>>>
import os
>>> os.rename('ohno.txt', 'ohwell.txt')
ایجاد پیوند با استفاده ازlink()
و symlink()
در سیستم
عامل یونیکس، فایلی که در یکجا وجود دارد، میتواند نامهای متفاوتی داشته باشد، که پیوند یا لینک (link)
نامیده میشوند. در سطوح پایین، لینکهایی هستند که لینک سخت (hard link)
نامیده میشوند، و این مسئله سادهای نیست تا همه نامهای یک فایل را پیدا کرد. یک لینک
نمادی، یا سمبولیک (symbolic
link)، روش دیگری برای ذخیره نام جدید بعنوان خودِ فایل است،
که باعث میشود بتوانید نام اصلی و نامهای جدید را یکباره بگیرید. فراخوانی تابع link()،
یک لینک سخت را ایجاد میکند، و فراخوانی symlink()، یک لینک سمبولیک ایجاد
میکند. تابع islink() بررسی میکند که آیا فایل، یک لینک سمبولیک است یا نه. در مثال زیر نشان داده میشود که چگونه برای یک فایل موجود بنامoops.txt یک لینک سخت بنام yikes.txt
ایجاد شود:
>>>
os.link('oops.txt', 'yikes.txt')
>>> os.path.isfile('yikes.txt')
True
برای
ایجاد یک لینک سمبولیک
بنام jeepers.txt از روی فایل موجود oops.txt:
>>> os.path.islink('yikes.txt')
False
>>>
os.symlink('oops.txt', 'jeepers.txt')
>>>
os.path.islink('jeepers.txt')
True
...........................................
برای ادامه مطالعه این فصل نسخه کامل PDF کتاب را تهیه کنید.
فصل 11
همزمانی و شبکه
زمان چیزیست
که از روی دادنِ یکباره همهچیزها باهم جلوگیری میکند. فضا چیزیست که از روی دادنِ همهچیز بر من
جلوگیری میکند.
نقلقولهایی درباره زمان
تا اینجا
بیشتر برنامههایی که نوشتیم در یک مکان (یعنی در یک
کامپیوتر تکی)، و در یک خط از زمان (یعنی بصورت متوالی sequential)
اجراء میشدند. ولی ما میتوانیم همزمان چندین کار را
با هم انجام دهیم (همزمانی concurrency)،
و همچنین میتوانیم آنها را مکانهای مختلف انجام دهیم (رایانش توزیعشده distributed
computing یا شبکه networking).
دلایل فراوانی برای به چالش کشیدن مکان و زمان وجود دارد، از جمله:
·
کارایی (Performance): در اینجا هدف شما این است که اجزاء
پرسرعت را مشغول نگاه دارید، نه اینکه منتظرِ اجزاء کمسرعت بمانید.
· توانمندی (Robustness):
داشتن تعداد بیشتری از هر چیزی موجب اطمینان خاطر است، بنابراین شما میخواهید تعداد کارهای درحالِ انجام را چند برابر کرده تا در برابر مشکلات نرمافزاری و سختافزاری مقاوم شوید.
·
سهولت (Simplicity):
بهترین روش انجام یک کار پیچیده
این است که آن کار به کارهای کوچکتری تقسیم شود که انجام آنها آسانتر و قابلفهمتر است.
·
ارتباط (Communication):
بسیار خوب خواهد بود اگر بتوانید دادههای خود را به
مکانهای دور دست بفرستید، و متقابلاً اطلاعاتی را دریافت کنید.
ما
کار خود
را با مبحث همزمانی شروع
کرده، و ابتدا از تکنیکهایی غیر-شبکهای که در فصل 10 به آنها اشاره شد (یعنی پروسهها و ریسهها) استفاده میکنیم. سپس رویکردهای دیگر، مثل پاسخدهندهها (callbacks)،
ریسههای سبز (green threads)،
و همروالها (coroutines)
را بررسی خواهیم کرد. و نهایتاً به شبکه بعنوان ابزاری برای چندپردازی خواهیم رسید.
برخی از پکیجهایی که در این فصل توضیح داده
شده هنوز به پایتون 3 انتقال داده نشدهاند. در بسیاری موارد، من مثالهایی را مطرح
کردهام که لازم است در مفسر پایتون 2 اجراء شوند.
همزمانی
سایت رسمی
پایتون مبحث همزمانی را
بصورت کلی در کتابخانه استاندارد خود مورد بحث قرار میدهد. این سایت شما را به پکیجها و تکنیکهای گوناگونی ارجاع میدهند که ما در این فصل مفیدترین آنها را
بررسی میکنیم.
اگر
چیزی شما را در کامپیوتر معطل نگاه دارد، احتمالاً آن چیز یکی از موارد زیر خواهد
بود:
محدودیتهای I/O (I/O
bound)
این یکی
از متداولترین عوامل است. مضحک است، ولی سرعت پردازنده (CPU)
یک کامپیوتر صدها برابر حافظه، و هزاران برابر دیسک یا شبکه آن است. و همین باعث کندی
برنامهها میشود.
محدودیتهای پردازنده (CPU bound)
هنگامی
که تعداد کارهای خُردکننده (crunching)،
مثلاً محاسبات علمی یا گرافیکی بالا رود، این تاثیر مستقیمی بر روی پردازنده
کامپیوتر خواهد داشت و آن را کند میکند.
دو
اصطلاح دیگر نیز در ارتباط با
همزمانی مطرح
میشوند:
همگامی (synchronous)
یک چیز
بدنبال چیز دیگری میآید.
ناهمگامی (asynchronous)
کارها مستقل
از یکدیگرند.
همانطور
که از کارهای ساده گذر کرده و به مشکلات روزمره برخورد میکنید، بالاخره سر و کارتان به همزمانی میافتد. برای مثال، یک وب سایت را در نظر بگیرید. شما سریعاً میتوانید صفحات ایستا و پویایی را برای سرویس گیرندههای خود فراهم آورید. اگر اینکار کسری از ثانیه طول بکشد، یک عملکرد تعاملی
بحساب میآید، ولی اگر تعامل با سایت، یا نمایش
اطلاعات بازگردانده شده، بیشتر طول بکشد، حوصله مشتریان شما سر خواهد رفت.
آزمایشاتی که توسط شرکتهایی نظیر گوگل و آمازون بعمل آمده نشان میدهد حتی اگر بارگذاری صفحات کمی کندتر شود، این باعث پایین آمدن آمار بازدید کنندگان سایت میشود.
وقتی
یک فایل آپلود میشود، یک تصویر تغییر اندازه داده میشود، و یا از یک پایگاه داده پُرس و جو میشود، اینجا جزء مواردی هستند که ما نمیتوانیم کاری در
مورد طولانی بودن آنها انجام دهیم. پس در چنین مواردی تکلیف چیست؟ نوشتن برنامههای همگام (synchronous)
برای سرویسدهندهها، تاثیر زیادی برای کاستن از اینگونه تاخیرها ندارد.
اگر
بخواهید چندین کار را
فقط توسط یک کامپیوتر بسرعت انجام دهید، باید آنها را بصورت جداگانه و مستقل از یکدیگر
انجام دهید. در فصل 10 در بخش مربوط به ریسهها دیدید که چگونه چندپردازی میتواند کارها را در یک کامپیوتر تَکی تقسیم
کند. اگر قرار است یک تصویر تغییر اندازه شود، برنامه سرویسدهنده میتواند پروسه
جداگانهای را فراخوانی کند که کار آن فقط تغییر اندازه تصاویر است.
این پروسه همزمان با برنامههای دیگر، و بصورت ناهمگام با آنها، در
سرویسدهنده اجراء میشود. اجراء همزمانِ چندین پروسهِ تغییراندازه، باعث گسترش افقی برنامه شما خواهد شد.
در
اینگونه موارد، کار کردن
این پروسهها با یکدیگر است که مشکل بوجود میآورد. ولی داشتن هرگونه وضعیت مشترک (یا کنترل مشترک) میان پروسهها، به معنی پیش آمدن تنگناها مختلف است. حتی مشکل بزرگتر این است که چگونه با
بروز این مشکلات برخورد شود. دلیل آن هم این است که رایانش
همزمان (concurrent
computing) سختتر از رایانش معمولی است. در اینجا احتمال
خراب شدن خیلی از چیزها وجود دارد، و احتمال موفقیت نهایی شما کمتر است.
برای
غلبه بر این مشکلات از چه روشهایی میتوان استفاده کرد؟ بیایید با صَفها، که روش خوبی
برای مدیریت چندین کار هستند،
کارمان شروع کنیم.
یک
صف (queue)
شبیه یک لیست است. این یعنی، چیزها از یک سرِ صف به آن اضافه شده، و از سر دیگر آن
خارج میشوند. به این نوع ساختار در علوم رایانهای FIFO میگویند.
فرض
کنید مشغول ظرف شستن هستید. اگر بخواهید اینکار را خوب انجام دهید، باید هر ظرف را
شسته، آنرا خشک کرده، و به کناری بگذارید. شما میتوانید اینکار را به طرق مختلفی انجام دهید. مثلاً میتوانید اولین ظرف را بشویید، خشک کنید، و سپس آنرا کنار بگذارید، و سپس همین مرحل را برای ظروف دوم، سوم، و ...
تکرار کنید.
یا میتوانید کارها را بصورت دستهای (batch)
انجام دهید و ابتدا کلیه ظروف را بشویید، بعد آنها را خشک کنید، و سپس آنها را جمع
کنید؛ در اینجا فرض میکنیم که سینکِ ظرفشویی و خشککن شما گنجایش همه ظروف را دارد.
شما
بعنوان یک راهحل جایگزین میتوانید از دو نفر دیگر کمک بگیرید. اگر کار شستن را خودتان برعهده بگیرید، میتوانید هر ظرفی را که میشویید به نفر بعدی بدهید که کار خشک کردن
بشقابها را بر عهده دارد، و او نیز پس از خشک کردن هر ظرف، آنرا به نفر بعدی که
وظیفه جمع کردن آنها را برعهده دارد بدهد. تا زمانی که هر سه شما با یک سرعت کار
کنید، کارها بسیار زودتر از زمانی به پایان میرسد که بخواهید به تنهای آنها را انجام دهید.
ولی
اگر شما نسبت شخصی که ظروف را خشک میکند با سرعت
بیشتری آنها را بشویید، آنوقت چه میشود؟ در اینصورت ظروف خیس روی زمین خواهند
افتاد، یا بین شما و کسی که آنها را خشک میکند تَلنبار خواهند
شد، شاید هم تا زمانی که خشک کننده کارش تمام نشده شما به صوت زدن بپردازید! و اگر
هم شخص سوم، یعنی جمع کننده ظروف، کندتر از خشک کننده باشد، باز هم یا ظرفها رویهم جمع میشوند، یا بر روی زمین میافتند، یا اینکه اینبار تا وقتی جمع کننده
کارش به پایان نرسیده خشک کننده به صوت زدن خواهد پرداخت! در اینحالت درست است که
شما چندین کارگر دارید، ولی رویهم رفته، کار بصورت همگام جلو میرود، و سرعت پیشرفت آن نیز با کمسرعتترین کارگر برابر خواهد بود.
یک
ضربالمثل قدیمی هست که میگوید ”همدستی چند کارکن باعث سبکتر شدن کار میشود“. اضافه کردن
کارگران بیشتر میتواند بر سرعت شستشوی ظرفها بیافزاید. اینکار مستلزم صفها است.
بطور
کلی، کار صفها این است که پیغامها (messages)
را انتقال دهند. این پیغامها میتوانند هر نوع اطلاعاتی باشند. در اینجا ما
از صفها برای کارهای توزیع شده استفاده میکنیم. این صفها به نامهایی نظیر صفهای کاری، نیز شناخته میشوند.
هر ظرفی که در ظرفشویی قرار دارد، به یک شوینده قابل دسترس داده میشود، که او نیز پس از اتمام کارش آنرا به اولین خشک کننده قابلدسترس میدهد، و او نیز آنرا به اولین جمعکننده قابلدسترس خواهد داد. این کار هم میتواند بصورت همگام (synchronous)
انجام شود (کارگران منتظر میمانند تا ظرفی به آنها داده شود و منتظر میمانند تا کارگری پیدا شود تا ظرف را از آنها بگیرد)، یا میتواند ناهمگام (asynchronous)
باشد (ظروف مابین کارگرانی که سرعتهای متفاوتی دارند جمع میشوند). تا زمانی که شما به اندازه کافی کارگر داشته باشید، و آنها مشغول ظرف
شستن باشند، کارها خیلی سریعتر جلو میروند.
شما میتوانید به طرق بسیاری صفها را پیادهسازی کنید. برای یک کامپیوتر تَکی، ماجول چندپردازی کتابخانهِ استاندارد حاوی یک
تابعِ صف میباشد. بیایید حالتی را شبیهسازی کنیم که در آن یک پروسه شوینده و چندین پروسه خشککن وجود دارد و در آن از صفِ ظروف استفاده کنیم (بعداً یکی پیدا میشود و ظرفهای خشک شده را جمع میکند!).
نام
این برنامه را dishes.py
بگذارید:
import multiprocessing as mp
def washer(dishes, output):
for dish
in dishes:
print('Washing',
dish, 'dish')
output.put(dish)
def dryer(input):
while True:
dish = input.get()
print('Drying',
dish, 'dish')
input.task_done()
dish_queue = mp.JoinableQueue()
dryer_proc
= mp.Process(target=dryer, args=(dish_queue,))
dryer_proc.daemon = True
dryer_proc.start()
dishes = ['salad',
'bread', 'entree', 'dessert']
washer(dishes,
dish_queue)
dish_queue.join()
به
طریق زیر برنامه جدید خود را اجراء کنید:
$ python dishes.py
Washing
salad dish
Washing
bread dish
Washing
entree dish
Washing
dessert dish
Drying
salad dish
Drying
bread dish
Drying
entree dish
Drying
dessert dish
این
صف که یک سری از ظروف
را تولید میکند، شباهت زیادی با یک تکرار کننده ساده پایتون دارد. در واقع این پروسههای جداگانهیی را همراه با ارتباط بین شوینده و خشککننده شروع میکند. در اینجا من از یک صف JoinableQueue، و متد نهایی join() استفاده کردم تا شوینده بداند کلیه ظروف خشک شدهاند. در ماجول multiprocessing ، گونههای دیگری از صفها موجود هستند، که برای اطلاع از آنها میتوانید به مستندات اینترنتی مربوطه رجوع کنید.
ریسهها
یک ریسه (thread)
در داخل یک پروسه اجراء
میشود تا به کلیه چیزهای آن پروسه دسترسی داشته باشد،
درست شبیه یک شخصیت چندگانه. ماجول multiprocessing،
پسر عمویی بنام threading داراد که بجای پروسهها از ریسه استفاده میکند (در واقع قدمت ماجول threading از multiprocessing
بیشتر است). بیایید تا چگونگی ایجاد ریسهها را ببینیم:
import threading
def do_this(what):
whoami(what)
def whoami(what):
print("Thread %s says: %s" % threading.current_thread(), what))
if __name__ == "__main__":
whoami("I'm the main
program")
for n in range(4):
p
= threading.Thread(target=do_this,
args=("I'm
function %s" %
n,))
p.start()
آنچه
برای من چاپ میشود این است:
Thread
<_MainThread(MainThread, started 140735207346960)> says:
I'm the main program
Thread
<Thread(Thread-1, started 4326629376)> says: I'm
function 0
Thread
<Thread(Thread-2, started 4342157312)> says: I'm
function 1
Thread
<Thread(Thread-3, started 4347412480)> says: I'm
function 2
Thread
<Thread(Thread-4, started 4342157312)> says: I'm
function 3
حالا
ظرفشویی خودمان را که قبلاً بر اساس پروسهها بنا کردیم، اینبار با استفاده از ریسهها میسازیم:
import threading, queue
import
time
def washer(dishes, dish_queue):
for dish
in dishes:
print ("Washing",
dish)
time.sleep(5)
dish_queue.put(dish)
def dryer(dish_queue):
while True:
dish
= dish_queue.get()
print ("Drying",
dish)
time.sleep(10)
dish_queue.task_done()
dish_queue = queue.Queue()
for n in range(2):
dryer_thread = threading.Thread(target=dryer, rgs=(dish_queue,))
dryer_thread.start()
dishes = ['salad',
'bread', 'entree', 'desert']
washer(dishes,
dish_queue)
dish_queue.join()
تفاوتی
که میان چندپردازی و چندریسهای وجود دارد این است که چندریسهای تابعی بنام terminate() ندارد. راه سادهای برای پایان دادن به یک ریسهِ درحالِ اجراء وجود ندارد، زیرا این میتواند موجب بوجود آمدن مشکلات زیادی در برنامه شما شود.
...........................................
برای ادامه مطالعه این فصل نسخه
کامل PDF کتاب را تهیه کنید.
فصل 12
چگونه یک
برنامهنویس پایتونِ واقعی شوید
اگر خواسته شما
همیشه این بوده که به زمان گذشته سفر کرده و با نسخه جوانتر خود مبارزه کنید، شغلی
که باید انتخاب کنید برنامهنویسی کامپیوتر است.
الیوت لو
(برنامهنویس)
این فصل
به هنر و علمِ برنامهنویسی پایتون اختصاص دارد، آنهم با تکیه بر
روی ”بهترین اسلوب“.
اگر این اسلوبها را یاد بگیرید، شما میتوانید یک برنامهنویس واقعی پایتون، یا اصطلاحاً یک پایتونیست (Pythonista)،
شوید.
نکاتی
درباره برنامهنویسی
ابتدا اجازه
دهید براساس تجربیات شخصی خودم، نکاتی را درباره برنامه نویسی مطرح کنم.
شغل
اولیه من در زمینه علوم بود، و برای اینکه بتوانیم دادههای تجربی خودم را تحلیل کنم، برنامهنویسی یاد گرفتم.
من انتظار داشتم برنامهنویسی کامپیوتر مانند امور حسابداری باشد
(دقیق و ملالآور). ولی بعداً پیبردم که اینکار چقدر میتواند لذت بخش باشد. بخشی از این لذت بخاطر
جنبههای منطقی آن بود (درست مثل حل کردن یک معما)، ولی
بخش دیگر نیز به خلاقیت مربوط میشد. شما برای گرفتن نتایجِ صحیح، مجبورید
برنامه صحیحی بنویسید، ولی آزادی آن را دارید که هر جور که میخواهید آن را بنویسید. در اینجا یک نوع تعادل غیرمعمولی بین تفکر سمتراست و تفکر سمتچپ مغز وجود داشت.
بعد
از اینکه کار من
کلاً به سمت برنامهنویسی منحرف شد، متوجه شدم که نرمافزار حوزههای زیادی را پوشش میدهد و متخصصین آنها کارهای کاملاً متفاوتی را انجام میدهند: گرافیک کامپیوتری، سیستمعاملها، تولید برنامههای اداری/تجاری (و حتی علمی).
اگر
یک برنامهنویس باشید، ممکن است تجربه مشابهای را داشته باشید. اگر هم نباشید، ممکن است کمی برنامهنویسی کرده باشید تا ببینید با مذاق شما جور است، و یا حداقل آن کاری که
انتظار دارید را برای شما انجام میدهد یا نه. همانطور که در ابتدای این کتاب
اشاره کردم،
داشتن مهارتهای ریاضی خیلی مهم نیستند. بنظر میرسد توانایی تفکر منطقی بیشترین اهمیت را دارد، و استعداد یادگیری زبان نیز در
این امر کمک میکند. نهایتاً اینکه، وقتی مشغول رفع اشکالات
برنامه خود هستید، داشتن صبر و حوصله مهم است.
یافتن
برنامههای پایتون
وقتی نیاز
دارید برنامهای را بنویسید، سریعترین راه این است که آن
را از جایی سرقت کنید! البته...
سرقت از جایی که سرقت کردن از آن مجاز است.
برای
این منظور، کتابخانه استاندارد پایتون بسیار گسترده، عمیق، و روشن است. آن را
بررسی کنید و آنچه مورد نظرتان است را بردارید.
مانند
تالار مشاهیر که ورود هنرمندان و ورزشکاران به آن طول میکشد، برای ماجولهای مختلف نیز زمان میبرد تا به کتابخانه استاندارد راه پیدا کنند. پکیجهای جدید پیوسته از راه میرسند، و من در طول این کتاب به برخی از آنها
که کارهای جدیدی را انجام میدهند، و یا کارهای قدیمی را بهتر انجام میدهند، اشاره کردهام. یکی از شعارهای پایتون این است که میگوید ”پایتون باطری سرخود است batteries included“، و این اشاره به کتابخانه استاندارد است که
همراه پایتون آمده. ولی با اینحال ممکن است شما هر از چندگاهی نیاز به یک باطری
جدید داشته باشید.
پس،
جدا از کتابخانه استاندارد پایتون، برای یافتن برنامههای خوب کجا را باید جستجو کرد؟
اولین
جایی که باید به آن نگاهی بیاندازید فهرست پکیجهای پایتون، یا PyPI،
است. این سایت بطور پیوسته درحال بروز شدن است، و فهرستی بزرگی از پکیجهای پایتون را برای شما فراهم میآورد (در زمان
نوشتن این کتاب حدود 39,000 پکیج در آن فهرست شده بود).
وقتی از pip استفاده میکنید، این برنامه برای یافتن پکیج موردنظر شما PyPI را جستجو میکند. صفحه اصلی PyPI
آخرین پکیجهای اضافه شده را نشان میدهد. شما همچنین میتوانید بصورت مستقیم در آن جستجو کنید.
یک
منبع پرطرفدار دیگر برای برنامههای پایتون GitHub
است. به سایت GitHub
بروید و پکیجهای پرطرفدار پایتون را مشاهده کنید.
سایت
”Popular Python recipes“
نیز دارای بیش از هزار برنامه کوچک پایتون برای موضوعات مختلف است.
چگونگی
نصب پکیجها
سه روش
برای نصب پکیجهای پایتون وجود دارد:
·
(در صورت امکان) استفاده از pip. شما میتوانید بیشتر پکیجهای پایتون که با آنها مواجه میشوید را توسط pip
نصب کنید.
·
در برخی از سیستمعاملها شما برای نصب پکیجها میتوانید از سیستم مدیریت پکیج استفاده کنید.
·
استفاده از منبع برنامه و نصب
آن بصورت دستی.
درصورتی
که میخواهید چندین پکیجِ مربوط به هم را نصب کنید،
برخی از توزیعهای پایتون هستند که از قبل چنین پکیجهایی را در خود دارند. برای مثال، در ضمیمه C این کتاب شما با تعدادی از
پکیجهای عددی و علمی آشنا میشوید که نصب آنها به تنهایی خسته کننده است، ولی آنها در برخی از توزیعهای پایتون، مانند Anaconda،
قرار داده شدهاند.
پکیجسازی پایتون محدودیتهایی دارد. قبلاً برای پایتون یک ابزار نصب
کننده بنام easy_install وجود داشت که بعداً
با pip
جایگزین شد، ولی هیچ کدام از آنها در پایتون استاندارد جا داده نشدهاند. ولی اگر قرار باشد با استفاده از pip چیزی را نصب کنیم، خود pip چگونه نصب میشود؟ با ظهور پایتون 3.4، سرانجام pip به پایتون اضافه شد. ولی اگر
از نسخههای قدیمیتر پایتون 3 استفاده میکنید، میتوانید با مراجعه به سایت
http://www.pip-installer.org
آن را دریافت کنید.
سادهترین استفادهای که میتوان از pip
نمود، نصب جدیدترین نسخه یک پکیج است. مثلاً برای flask، اینکار بصورت زیر انجام میشود:
$ pip
install flask
برای
اینکه فکر نکنید pip بیکار است، کلیه جزئیات کارها روی صفحه نمایش داده میشود: دانلودها، اجراء setup.py، نصب فایلها بر روی دیسک، و جزئیات دیگر.
شما
همچنین میتوانید از pip بخواهید نا نسخه بخصوصی از یک
پکیج را برای شما نصب کند:
$ pip
install flask==0.9.0
یا
میتوانید درخواست کنید که حداقل نسخهای که نصب میشود، از یک شماره کمتر نباشد (اینمورد زمانی
مفید است که میخواهید از خصوصیاتی استفاده کنید که از یک
نسخه خاص به-بعد
به پکیج اضافه شدهاند):
$ pip install 'flask>=0.9.0'
کوتیشنهایی که در مثال فوق بکار رفتهاند برای این است که پوسته سیستمعامل علامت >
را طوری تعبیر نکند که انگار شما میخواهید خروجی را به فایلی بنام 0.9.0 هدایت کنید.
اگر
میخواهید چندین پکیج پایتون را با هم نصب کنید، از یک
فایل متنی استفاده
کنید. گرچه میتوانید گزینههای زیادی را در این فایل بکار بگیرید، ولی سادهترین حالت این است که در هر خط نام پکیجی که میخواهید نصب شود را ذکر کنید، و در صورت لزوم شماره نسخه آن را هم مشخص کنید:
$ pip
-r requirements.txt
محتوای
فایل requirements.txt
که در دستور فوق
از آن استفاده شده میتواند بصورت زیر باشد:
flask==0.9.0
django
psycopg2
برای
سیستم عامل OS X Apple،
2 برنامه
مدیریت پکیج شخصثالث، بنامهای homebrew (brew)
و ports وجود دارد.
آنها بیشتر شبیه pip
هستند، ولی عملکرد آنها به نصب پکیجهای پایتون محدود نمیشود.
لینوکس
برای هر یک از توزیعهای خود (Ubuntu, Redhat, …) دارای مدیریت
متفاوتی است. پرطرفدارترین آنها apt-get،
yum، dpkg و zypper هستند.
مدیریت
برنامهها در ویندوز توسط Windows Installer انجام میشود و پسوند فایلهایی که این برنامه از آنها استفاده میکند .msi است. اگر پایتون را بر روی ویندوز نصب کردهاید، احتمالاً برای اینکار از یک فایل .msi استفاده کردهاید.
ضمیمه
A
کاربرد
پایتون در هنر
ممکن است
شما یک هنرمند، یا موسیقیدان باشید. شاید هم فقط میخواهید یک چیز متفاوت و خلاقانه را امتحان کنید.
ما
در سه ضمیمه نخست این کتاب، کاربردهای پایتون در حوزههای مختلف را مرور خواهیم کرد. اگر به یکی از این حوزهها علاقهمند هستید، ممکن است بتوانید از این مطالب
ایدههایی را کسب کنید، یا تشویق شوید کار جدیدی را انجام دهید.
گرافیک
2-بُعدی
در گرافیک
کامپیوتری، تقریباً از همه زبانها، به درجات مختلف، استفاده شده است. به
منظور سرعت بیشتر، بسیاری از چهارچوبهای سنگینی که در این فصل معرفی میشوند به زبانهای C
یا C++ نوشته شدهاند، و برای بهرهوری بیشتر به کتابخانه استاندارد پایتون
اضافه گشتهاند. بیاید به کتابخانه تصاویر 2-بُعدی
نگاهی بیاندازیم.
تنها
تعداد اندکی ماجول برای
انجام کارهای گرافیکی
در کتابخانه استاندارد هستند. دو تای آنها عبارتند از:
imghdr
این ماجول میتواند گونه برخی
از فایلهای تصویری را تشخیص دهد.
colorsys
این ماجول رنگِ سیستمهای مختلف (RGB, YIQ, HSV,
و HLS) را به یکدیگر تبدیل میکند.
اگر
شما لوگو شرکت O’Reilly
را در فایلی بنام oreilly.png دانلود کنید، میتوانید برنامه زیر را اجراء کنید:
>>>
import imghdr
>>> imghdr.what('oreilly.png')
'png'
در
پایتون برای انجام کارهای گرافیکی مهم، نیاز است از پکیجهای شخص ثالث استفاده شود. در زیر به برخی از آنها اشاره میکنم.
PIL و Pillow
هرچند PLI (Python Image Library) جزیی از کتابخانه
استاندارد نیست، ولی سالها است که این پکیج بعنوان معروفترین کتابخانه پردازش
2-بعدی پایتون محسوب میشود. قدمت برنامه نصب کننده PIL به پیش از برنامههایی نظیر pip
باز میگردد، بنابراین انشعابی (fork)
از آن بنام Pillow ایجاد شد. برنامه Pillow با PIL سازگار است، و مستندات خوبی
نیز دارد، بنابراین ما از آن استفاده میکنیم.
نصب
این برنامه ساده است:
$ pip
install Pillow
درصورتی
که پکیجهایی نظیر libjpeg, libfreetype, و zlib
را بر روی کامپیوتر خود داشته باشد، آنها توسط Pillow
تشخیص و بکارگرفته خواهند شد. برای
اطلاعات بیشتر به صفحه اینترنتی Pillow مراجعه کنید.
یک
فایل تصویری را بازمیکنیم:
>>>
from PIL import Image
>>>
img = Image.open('oreilly.png')
>>>
img.format
'PNG'
>>>
img.size
(154, 141)
>>> img.mode
'RGB'
هرچند
نام پکیج Pillow است، ولی به منظور اینکه با PIL
قدیمی سازگار باشد، شما آن را بعنوان PIL
وارد میکنید.
برای
نمایش تصویر بر روی صفحه، شما باید از متد show()
استفاده کنید، ولی پیش از آن باید پکیج ImageMagick را نصب کرده باشید.
>>>
img.show()
تصویری که
در شکل A-1 نمایش داده شده، در
پنجره دیگری باز میشود (این تصویر با استفاده از کامپیوتر اپل
نمایش داده شده. اگر از ویندوز استفاده میکنید ممکن است
شکل آن متفاوت باشد).
شکل A-1. تصویری که با استفاده از PIL باز شده است
حالا
بیایید تصویر را بِبُریم (crop)
و نتیجه را در شیئی بنام img2
ذخیره کرده و آن را نمایش دهیم. تصاویر همیشه بوسیله مقادیر افقی (x) و عمودی آنها (y) اندازهگیری میشوند، که یکی از گوشههای تصویر بعنوان مبداء (origin)
شناخته میشود و مقدارِ x و y آن 0 است. در این
کتابخانه، مبداءِ (0,0) گوشه بالایی سمت چپ تصویر
است، که x به سمت راست، و y به سمت پایین، افزایش مییابند. ما میخواهیم تصویر را بصورتی بُرش بزنیم که گوشه
بالایی آن از سمت چپ مقدارِ x(55)،
و از بالا مقدارِ y(70) و از راست مقدارِ x(85) و از پایین مقدارِ y(100) را
داشته باشد. پس به همین ترتیب، ما این مقادیر را به متد crop()
میدهیم:
>>>
crop =
(55, 70,
85, 100)
>>> img2 = img.crop(crop)
>>>
img2.show()
حاصل
این کار در
شکل A-2 نشان داده شده است.
شکل A-2.
تصویر بُریده شده
از
متد save() برای ذخیره یک تصویر
استفاده کنید. این متد یک نام، و یک گونه اختیاری میگیرد. درصورتی که
نام فایل حاوی یک پسوند باشد، کتابخانه از آن برای تشخیص گونه استفاده میکند. ولی شما میتوانید گونه فایل را بطور صریح مشخص کنید.
برای ذخیره تصویر بُریده شده به فرمتِ GIF، موارد زیر را انجام دهید:
>>>
img2.save('cropped.gif', 'GIF')
>>>
img3 = Image.open('cropped.gif')
>>>
img3.format
'GIF'
>>>
img3.size
(30, 30)
ضمیمه
B
کاربرد
پایتون در تجارت و کسب و کار
ما از
کلیه تکنولوژیهایی که در فصول قبلی به آنها اشاره شد (پایگاه داده، وِب، سیستم، و شبکه) در تجارت
استفاده میکنیم. قابلیتهای پایتون باعث شده تا در دنیای کسب و کار و شرکتهای نوظهور (startups)
طرفداران زیادی داشته باشد.
شرکتهای
تجاری همیشه بدنبال این بودهاند که مشکلات دیرین خود را برطرف کنند
(ناسازگاری فرمت فایلها، پروتکلهای متفاوت شبکه، قفلهای نرمافزاری، و فقدان مستندسازی عمومی و دقیق). ولی امروزه تکنولوژیها و تکنیکهایی وجود دارند که حقیقتاً میتوانند با یکدیگر کُنش داشته باشند و گسترش یابند. در دنیای تجارت با بکارگیری موارد
زیر میتوان برنامههایی سریعتر، ارزانتر، و قابلگسترشتری را تولید کرد:
· استفاده از زبانهای پویا مثل
پایتون
· استفاده از وب بعنوان یک رابطِ کاربر گرافیک عمومی
·
استفاده از APIهای RESTful بعنوان نوعی میانجی مستقل از زبان برای سرویسها
·
استفاده از پایگاههای رابطهای و نیز NoSQL
·
استفاده از تکنیکهای ”دادههای بزرگ“
·
استفاده از Cloud برای توسعه و صرفهجویی در سرمایه
مجموعه نرمافزارهای اداری مایکروسافت
دنیای کسب
و کار بطور
فزایندهای به مجموعه نرمافزارهای
اداری مایکروسافت (Microsoft
Office) و انواع فرمتهای آن وابسته است.
گرچه این فرمتها آنچنان شناخته شده نیستند، و در برخی
موارد مستنداتی کمی برای آنها وجود دارد، ولی با اینحال بعضی از کتابخانههای پایتون هستند که میتوانند این فایلها را بخوانند. در زیر فهرست
کتابخانههایی آمده که میتوانند فایلهای آفیس را بخوانند:
·
docx: این کتابخانه میتواند فایلهای مایکروسافت word، که به فرمت .docx
هستند را بخواند، بنویسد، یا آنها را ایجاد کند.
·
python-excel: این کتابخانه برای
رسیدگی به فرمتهای مرتبط با اکسل، مانند xlrd, xlwt
کاربرد دارد. اکسل مایکروسافت میتواند مقادیر جدا شده با کاما (در فایلهای CSV) را بخواند و بنویسد. این
فایلها توسط ماجول csv پایتون نیز قابل پردازش
هستند.
·
oletools: این کتابخانه میتواند دادهها را از فایلهای مختلف آفیس استخراج کند.
ماجولهای زیر برنامههای ویندوز را خودکار میسازند (automate).
·
pywin32 این ماجول بسیاری از برنامههای ویندوز را خودکار میسازد، ولی به پایتون 2 محدود است و مستندات
اندکی نیز دارد.
·
pywinauto این ماجول نیز برنامههای ویندوز را خودکار میسازد، ولی این نیز به پایتون 2
محدود است.
·
swapyاین
ماجول از
کنترلهای بومی استفاده میکند تا برای pywinauto برنامههای پایتون تولید کند.
OpenOffice جایگزینی برای آفیس مایکروسافت است. این برنامه بر روی Linux, Unix, Windows, و OS X اجراء میشود و میتواند فرمتهای مختلف آفیس را بخواند و بنویسد. این
برنامه همچنین برای کارهای خودش یک نسخه از پایتون 3 را نصب میکند. شما توسط کتابخانه PyUNO
میتوانید برای OpenOffice در پایتون برنامه بنویسید. صاحب اولیه OpenOffice کمپانی Sun بود. پس از اینکه Oracle شرکت Sun را خرید، خیلیها از آینده OpenOffice
و در دسترس بودن آن نگران شدند. به
همین دلیل انشعابی از آن بنام LibreOffice
بوجود آمد. برای خواندن و نوشتن فایلهای مایکروسافت، OpenOffice و LibreOffice مجبور بودند این فرمتها را مهندسی معکوس کنند، که کار آسانی نبود.
هر
چند PDF یکی از فرمتهای
مایکروسافت نیست، ولی استفاده از آن در تجارت بسیار رایج است. شما با استفاده از
کتابخانه ReportLab
میتوانید فایلهای PDF را در پایتون تولید کنید. اگر
به ویرایش فایلهای PDF نیاز دارید، میتوانید به سایت StackOverflow مراجعه کنید.
انجام
کارهای تجاری
تقریباً
برای انجام هر کاری شما میتوانید یک ماجول پایتون پیدا کنید. به سایت PyPI بروید و آنچه را میخواهید در آن جستجو کنید. در واقع بسیاری از ماجولهای موجود، واسطِ APIهای عمومیِ سرویسها هستند. ممکن است شما به مثالهای مرتبط با کارهای تجاری علاقهمند باشید. مثلاً:
·
فرستادن کالا بوسیله Fedex یا UPS.
·
فرستادن ایمیل با APIهای stamps.com.
·
OpenERP یک ERP
تجاری بزرگ است که به پایتون و جاوااسکریپت نوشته شده، و دارای هزاران ماجول افزونه است.
پردازش
دادههای تجاری
در دنیای
تجارت علاقه زیادی به دادهها وجود دارد. متاسفانه بسیاری از شرکتها از
روشهایی استفاده میکنند که بکارگیری دادهها را مشکل میکند.
صفحاتگسترده (Spreadsheets)
اختراع خوبی بود که پس از مدتی خیلی از کسب و کارها به آنها معتاد شدند. بسیاری از
مردم که برنامه نویس نبودند، بجای برنامهها از چیزهای
استفاده میکردند که ماکرو (macro)
نامیده میشوند. ولی کارها در حال گسترش بود و دادهها نیز درحال بزرگتر شدن. نسخههای قدیمیتر Excel محدود به
65,536 سطر بودند، و حتی نسخههای جدیدتر آن نیز به سختی میتوانند از یک میلیون سطر پشتیبانی کنند.
هنگامی که حجم دادههای سازمانی از محدوده یک کامپیوتر فرارتر
میرود، مثل این است که خودتان به تنهایی بخواهید
افرادی را شمارش کنید که تعداد آنها از صدها نفر بیشتر باشد. در چنین مواردی شما
به افراد بیشتر و ارتباطات نیاز دارید.
دلیل
اضافه شدن حجم دادهها این نیست که حجم دادهها در یک کامپیوتر بالا رفته، بلکه نتیجه انباشته شدن دادههایی است که هر روزه به تجارت وارد میشوند. پایگاههای داده رابطهای میتوانند بدون اینکه بازدهی آنها کم شود، میلیونها سطر از داده را پردازش کنند، ولی به شرطی که صحبت بر سر نوشتن تعداد معدودی
از سطرها در یک زمان باشد. حجم یک فایل متنی ساده، یا یک فایل باینری، میتواند به چندین گیگا بایت برسد،
ولی اگر لازم باشد چنین فایلهایی را به یکباره پردازش کنید، شما باید به اندازه
کافی حافظه داشته باشید. برنامههای دسکتاپ معمولی اصلاً برای اینکارها مناسب نیستند. شرکتهایی نظیر Google و Amazon
مجبور بودند برای رسیدگی به دادههایی با این ابعاد راهحلهایی را ابداع کنند. نمونهای از این برنامهها که با استفاده از پایتون و RESTful API، و بر اساس کلاد
آمازون ساخته شده Netflix است.
ضمیمه
C
کاربرد
پایتون در علوم
در چند
سال اخیر، عمدتاً بدلیل نرمافزارهایی که در این ضمیمه خواهید دید، پایتون
در میان دانشمندان محبوبیت بسیار زیادی پیدا کرده. اگر خودتان یک دانشمند یا
دانشجوی علوم هستید، ممکن است از ابزارهایی مانند MATLAB و R، یا زبانهای سنتی مانند Java، C، یا C++ استفاده کرده باشید. در این
ضمیمه خواهید دید که چگونه پایتون میتواند یک چهارچوب
بسیار عالی برای تجزیه و
تحلیل دادههای علمی و انتشار آنها باشد.
ریاضیات
و آمار در کتابخانه استاندارد
ابتدا
بیایید به کتابخانه استاندارد باز گردیم، و ویژگیهایی را بررسی کنیم که قبلاً آنها را نادیده گرفتیم.
کتابخانه
استاندارد پایتون گروه وسیعی از توابع ریاضی را در خود دارد. برای استفاده از آنها
کافیست دستور import
math را وارد کنید.
برای
مثال، در اینجا ثابتهایی همچون عدد π و e قابل دسترس هستند:
>>>
import math
>>> math.pi
>>>
3.141592653589793
>>> math.e
2.718281828459045
این
ماجول بیشتر
حاوی توابع ریاضی است، بنابراین بیایید پرکاربردترین آنها را بررسی کنیم:
تابع fabs() قدرمطلق آرگومان داده شده را بازمیگرداند:
>>>
math.fabs(98.6)
98.6
>>>
math.fabs(-271.1)
271.1
تابع
floor() آرگومان خود را به عدد صحیح کوچکتر، و تابع ceil() آرگومان خود را به عدد
صحیح بزرگتر گِرد میکنند:
>>> math.floor(98.6)
98
>>>
math.floor(-271.1)
-272
>>>
math.ceil(98.6)
99
>>> math.ceil(-271.1)
-271
تابع
factorial()، فاکتوریل یک عدد صحیح (یا n !)
را باز میگرداند:
>>> math.factorial(0)
1
>>>
math.factorial(1)
1
>>>
math.factorial(2)
2
>>> math.factorial(3)
6
>>> math.factorial(10)
3628800
تابع
log() لگاریتم یک عدد در مبنای e را بازمیگرداند:
>>> math.log(1.0)
0.0
>>>
math.log(math.e)
1.0
اگر
میخواهید لگاریتم را در مبنای دیگری حساب کنید، آن
مبنا را
بعنوان آرگومان دوم
تابع بدهید:
>>> math.log(8, 2)
3.0
تابع
pow() عکس تابع log() را
انجام میدهد و یک عدد را به توان عدد دیگری میرساند:
>>> math.pow(2, 3)
8.0
پایتون
دارای یک عملگر توانی نیز هست (**) که همین کار را انجام میدهد، ولی اگر
پایه و توان هر دو عدد صحیح باشند،
آنها را بصورت خودکار به عدد اعشاری تبدیل نمیکند:
>>> 2**3
8
>>> 2.0**3
8.0
جذر
یک عدد را توسط تابع sqrt() محاسبه کنید:
>>> math.sqrt(100.0)
10.0
سعی
نکنید چیز اشتباهی را به این تابع بدهید:
>>> math.sqrt(-100.0)
Traceback
(most recent call last):
File
"<stdin>", line 1, in
<module>
ValueError:
math domain error
کلیه
توابع مفید مثلثاتی نیز در دسترس هستند: sin(), cos(), tan(), asin(), acos(), atan(), و atan2().
اگر قضیه فیثاغورث را بخاطر داشته باشید، در اینجا نیز تابعی بنام hypot()
وجود دارد که میتواند با گرفتن دوضلع یک مثلث قائمالزاویه، طول وتر آن را برای شما باز گرداند:
>>> x =
3.0
>>> y =
4.0
>>>
math.hypot(x, y)
5.0
دو
تابع نیز برای تبدیل درجه
و رادیان به یکدیگر وجود دارد:
>>> math.radians(180.0)
3.141592653589793
>>>
math.degrees(math.pi)
180.0
کار با اعداد مختلط
در پایتون
از اعداد مختلط بطور
کامل پشتیبانی میشود، آنهم بشکل نمادگذاری ملموس آنها، که هم
جزء حقیقی، و هم جزء موهومی را در
بردارد:
>>> # یک عدد حقیقی
...
5
5
>>> # یک عدد موهومی
... 8j
8j
>>> # یک عدد مختلط
...
3 + 2j
(3+2j)
بدلیل
اینکه عدد موهومی i (در پایتون 1j) بعنوان ریشه دوم -1
تعریف شده، ما میتوانیم عبارات زیر را اجراء کنیم:
>>>
1j * 1j
(-1+0j)
>>> (7
+ 1j) * 1j
(-1+7j)
برخی
از توابع ریاضی مختلط در
ماجول استاندارد
cmath قرار دارند.
در کامپیوتر
اعداد اعشاری (یا ممیز شناور)، شباهت کاملی با اعداد حقیقی که در مدرسه یادگرفتهایم ندارند. بدلیل اینکه CPUها برای عملیات ریاضی باینری طراحی شدهاند، اعدادی که توان دقیقی از 2 نباشند نمیتوانند بصورت دقیق نمایش داده شوند:
>>> x =
10.0 / 3.0
>>> x
3.3333333333333335
حاصل
این عبارت باید تماماً از 3 تشکیل شده باشد، پس
این 5 که در پایان عدد آمده چیست؟ با استفاده از ماجول decimal میتوانید با هر دقتی که میخواهید اعداد را نمایش دهید. این ویژگی مخصوصاً برای محاسبات پولی اهمیت دارد. واحد
پولی آمریکا از یک سِنت (یکصدم دلار) کمتر نمیرود، بنابراین اگر ما پولی را بعنوان دلار محاسبهای کردیم، فقط میخواهیم تا حد سِنت دقیق باشد. اگر ما سعی
کنیم مقادیر دلار و سنت را بصورت اعداد ممیز شناور نشان دهیم (مثلاً19.99
و 0.06)، حتی قبل از اینکه
محاسبه خود را شروع کنیم دقت خود را از دست میدهیم. چگونه میتوان این مشکل را برطرف کرد؟ چاره این است
که بجای اعداد ممیز شناور از ماجول decimal
استفاده کنیم:
>>> from
decimal import Decimal
>>> price
= Decimal('19.99')
>>>
tax = Decimal('0.06')
>>>
total = price + (price * tax)
>>>
total
Decimal('21.1894')
ضمیمه
D
نصب
پایتون 3
متاسفانه
پایتون 3 روی همه کامپیوترها نصب نیست. ویندوز که
اصلاً هیچ پایتونی ندارد، و بر روی سیستمهای OS X، Linux، و Unix نیز، بیشتر نسخههای قدیمیتر پایتون نصب شده است. تا وقتی این روند ادامه
دارد، شما مجبور هستید خودتان پایتون 3 را نصب کنید.
در
بخشهای بعد
ما موارد زیر را توضیح خواهیم
داد:
· اگر پایتون بر روی کامپیوتر شما نصب شده، کدام نسخه
است.
· چگونگی نصبِ توزیعِ استاندارد پایتون 3.
·
چگونگی نصبِ توزیعِ علمی Anaconda.
·
چگونگی نصبِ pip و virtualenv.
·
چگونگی نصبِ conda بعنوان جایگزینی برای pip.
بیشتر
مثالهای این کتاب براساس پایتون 3.3 نوشته و آزمایش شدهاند. روشهای بسیاری برای نصب یک نسخه جدید پایتون
وجود دارد. از میان آنها من به دو روش اشاره میکنم.
·
اگر فقط میخواهید مفسر و
کتابخانههای استاندارد را داشته باشید، توصیه میکنم به سایت رسمی پایتون بروید.
·
اگر علاوه بر کتابخانه
استاندارد میخواهید به کتابخانههای علمی نیز دسترسی داشته باشید، از Anaconda استفاده کنید.
نصب
پایتون استاندارد
با مرورگر
خود به صفحه دانلود پایتون بروید. سایت تلاش میکند سیستم عامل شما را حدس بزند و انتخاب مناسبی را به شما عرضه کند، ولی اگر
اشتباه حدس زد، انتخابهای زیر برای شما وجود دارد:
·
پایتون برای ویندوز
·
پایتون برای Mac OS X
·
منبع پایتون (لینوکس و یونیکس)
صفحهایی شبیه آنچه در شکل D-1
آمده برای شما نمایش داده میشود:
شکل D-1. صفحه
دانلود پایتون.
روی
لینک جدیدترین
نسخه کلیک کنید. در زمان ما، این نسخه 3.5.1 است. با اینکار شما
به صفحه دیگری هدایت میشوید که شبیه شکل D-2 است.
شکل D-2. جزئیات صفحه دانلود
شما
باید آنقدر به پایین صفحه بروید تا لینک واقعی دانلود را ببینید (شکل D-3).
شکل D-3.
لینک دانلود در انتهای صفحه دیده میشود.
روی
لینک دانلود
بزنید تا به صفحه اصلی دانلود
بروید (شکل D-4).
شکل D-4.
فایلهای دانلود.
حالا
برای کامپیوتر خود نسخه
مناسب را انتخاب کنید.
بر روی
مورد “Mac OS X 64-bit/32-bit installer link” کلیک کنید تا یک فایل
را .dmg را دانلود کنید. پس از اینکه دانلود به
پایان رسید، روی فایل دابلکلیک کنید. پنجرهای با چهار آیکن باز میشود. بر روی Python.mpkg راست کلیک کنید، و سپس در دیالوگی که ظاهر شده، Open را انتخاب
کنید. سه بار بر روی دکمه Continue
کلیک کنید، و هنگامی که پنجره مناسب باز شد، مورد Install را انتخاب کنید. پایتون 3
در مسیر /usr/local/bin/python3 نصب خواهد شد.